향상된 Autoencoder를 통한 빅데이터 영상의 이상 탐지
Jul 12, 2023
1. 소개
높은 수준의 컴퓨터 비전 작업인 비디오 이상 감지는 주어진 비디오 시퀀스에서 비정상적인 이벤트를 자동으로 감지하여 비디오에서 비정상 활동과 정상 활동 및 비정상 범주를 효과적으로 구분할 수 있습니다. 지난 몇 년 동안 연구원들은 이상 탐지와 관련된 많은 연구를 수행했습니다[1-9]. 정상적인 사건과 비교하여 거의 발생하지 않거나 발생 가능성이 낮은 사건은 일반적으로 비정상적인 사건으로 간주됩니다. 그러나 현실적으로는 이벤트의 종류를 알 수 없고 이상에 대한 정의가 명확하지 않아 효과적인 이상 탐지 모델을 구축하기 어렵다. 기존의 이상 탐지 방법은 대부분 학습된 정상 패턴과 다른 패턴을 이상으로 간주한다는 가정하에 설계되어 있다. 이러한 가정에 따라 다른 시나리오에서 동일한 활동이 정상 또는 비정상 이벤트로 표시될 수 있습니다. 예를 들어, 두 사람이 길거리에서 싸우고 있는 싸움 장면은 비정상으로 간주될 수 있지만 두 사람이 권투를 할 때는 정상입니다. 또한, 고차원 비디오 데이터에는 중복된 시각 정보가 많아 비디오 시퀀스에서 이벤트 표현의 어려움이 가중됩니다.

중국 허브 시탕슈
이전 연구에 따르면 이상 탐지 방법은 일반적으로 두 가지 유형으로 나눌 수 있습니다. 일부 이상 감지 방법은 재구성 오류를 통해 설계되었으며 비디오 시퀀스의 정상적인 패턴을 모델링하는 데 중점을 둡니다[3-5, 7, 8, 10, 11]. (이러한 방법은 학습 단계에서 정상 패턴의 특징 표현 모델을 학습하고 비정상 샘플과 정상 샘플의 차이를 사용하여 테스트 단계에서 재구성 오류 또는 특정 임계값과 같은 테스트 데이터의 최종 비정상 점수를 결정합니다[7 -14] 재구성 기반 이상 탐지 방법은 비디오 시퀀스의 정상 패턴을 재구성하는 데는 우수하지만 이러한 방법의 핵심 문제는 학습 데이터에 크게 의존한다는 것입니다.또 다른 유형의 이상 탐지는 분류 문제로 간주됩니다. 15, 16] 이러한 방법은 훈련된 분류기를 사용하여 HOF(Histogram of Optical Fellow) 또는 DT(Dynamic Texture)와 같은 특징을 추출하여 비디오 시퀀스의 이상 점수를 예측합니다.(이러한 방법의 성능은 학습 샘플에 대한 의존도가 높으며 만족스러운 성능을 얻기 위해서는 이러한 이상 탐지 방법에 대해 효과적이고 차별적인 특징 추출이 필수적입니다[17-20]. 그러나 두 가지 유형의 방법은 일반적으로 비교적 간단한 방법으로 이벤트 간의 관계를 모델링합니다[7, 10, 21–23]. 예를 들어, 선형 관계만 고려되며 많은 실제 사례에서 복잡하고 고도로 비선형적인 관계에는 충분하지 않습니다.
사막 생활 cistanche
최근 몇 년 동안 딥 러닝 기반 방법이 비디오 탐지 분야에 적용되어 큰 발전을 이루었습니다[24-26]. 예를 들어, 오토인코더(AE)는 재구성 오류를 사용하여 이상을 감지하고 이를 기반으로 일련의 방법이 개선되었습니다. 또한 GAN(Generative Adversarial Network)과 LSTM(Long Short-Term Memory)도 이상 탐지 문제를 해결하기 위해 적용되었습니다. 그러나 AE는 강력한 일반화 능력을 가질 수 있으므로 비정상적인 이벤트를 재구성할 수 있습니다. [14]에서 연구원들은 비정상 훈련 샘플이 없기 때문에 비정상 샘플의 재구성을 예측할 수 없어 비정상 샘플에 대한 재구성 오류가 더 커질 수 있다고 지적했습니다. 일부 이상이 정상 훈련 데이터와 공통 구성 패턴을 공유하거나 디코더가 "너무 강해서" 일부 이상 코드를 잘 디코딩할 수 없는 경우 AE는 이상을 잘 재구성할 수 있습니다. AE의 단점을 극복하기 위해 본 논문에서는 메모리 모듈을 사용하여 deep AE를 강화하고 메모리 증강 AE(Memory AE) 방식을 개발한다. 새로운 테스트 샘플이 입력되면 Memory AE는 이를 직접 인코딩하여 디코더에 입력하는 것이 아니라 메모리 모듈에서 해당 콘텐츠를 검색하는 쿼리로 사용합니다. (en, 콘텐츠가 집계되어 디코더로 전달됩니다. 프로세스는 어텐션 어드레싱에 의해 실현됩니다. 또한 이 백서는 메모리 어드레싱 가중치의 희소성을 유도하기 위해 차별화 가능한 축소 연산자를 사용하여 메모리 콘텐츠가 기능의 쿼리에 접근하도록 장려할 수 있습니다. 교육 단계에서 인코더와 디코더는 동시에 메모리 모듈을 업데이트하여 더 낮은 평균 재구성 오류를 얻습니다. 테스트 단계에서는 학습된 메모리 내용이 고정되고 소량의 일반 메모리 항목이 사용됩니다. 이들을 입력 코드의 이웃으로 선택하면 재구성 오류가 매우 명백할 것입니다.여러 공개 벤치마크 데이터 세트에 대한 실험은 Memory AE의 감지 성능이 최첨단에 도달했음을 보여줍니다.

Cistanche deserticola의 주요 화학 성분
2. 알고리즘 원리
그림 1은 Memory AE의 전체 네트워크 구조를 보여주며 인코더(입력 인코딩 및 쿼리 생성에 사용), 디코더(재구성에 사용) 및 메모리 모듈(메모리 및 관련 주소 지정 작업 포함)의 세 가지 하위 구조로 나뉩니다. 그림 1에 표시된 것처럼 테스트할 이벤트가 주어지면 인코더는 먼저 코딩된 값을 얻습니다. 코딩된 값을 쿼리로 사용하여 메모리 모듈은 어텐션 기반 주소 지정 연산자를 통해 메모리 모듈에서 가장 관련성이 높은 콘텐츠를 검색한 다음 재구성을 위해 디코더로 전달합니다. 학습하는 동안 인코더와 디코더는 재구성 오류를 최소화하기 위해 매개변수를 최적화하는 동시에 인코딩된 일반 데이터의 프로토타입 요소를 기록하도록 메모리 모듈을 업데이트합니다. 테스트 샘플이 주어지면 모델은 재구성을 수행하기 위해 메모리 모듈에 기록된 제한된 정상 패턴만 사용합니다. 이런 식으로 재구성은 정상 샘플에 가까운 경향이 있습니다. 따라서 정상 표본의 재구성 오류는 작고 비정상 오류는 큽니다.
그림 1: (제안된 메모리 AE의 흐름도.

2.1. 인코더 및 디코더. (e 인코더와 디코더는 AE의 두 부분입니다. 전자는 입력 데이터를 특징 공간에 매핑하여 코딩된 값을 얻고 후자는 코딩된 값을 입력 데이터로 재구성합니다. (e AE는 다음으로 구성됩니다. 인코더 fw1(·) 및 디코더 gw2(·)는 다음과 같이 표현될 수 있습니다.

여기서 x와 x'는 각각 AE의 입력과 재구성된 입력이고, z는 x의 인코딩 결과이고, W1과 W2는 인코더와 디코더의 매개변수를 나타내며, 사이의 재구성 오차를 최소화함으로써 얻을 수 있다. x 및 x':

AE는 비정상 여부를 판단하기 위해 정상 샘플의 오류를 재구성[19, 20]함으로써 비정상 감지 작업을 해결하는 데 성공적으로 사용되었습니다. 그러나 비정상 샘플의 재구성은 예측할 수 없어 비정상 샘플에 대한 재구성 오류가 더 커질 수 있습니다. 이 문제를 해결하기 위해 2.2절에서 AE에 메모리 모듈을 도입하고 Memory AE를 제안한다.
2.2. 메모리 모듈. (제안하는 방법은 프로토타입 인코딩 모드를 기록하기 위한 메모리 모듈과 메모리 모듈에 접근하기 위한 어드레싱 동작을 포함한다.
2.2.1. 주의 기반 표현. (e 어텐션 모듈은 N개의 실시간 벡터를 포함하는 행렬 M ∈ RN×C로 설계됩니다. 단순화를 위해 C가 z의 차원이라고 가정한 다음 Ζ � RC라고 합니다. 행 벡터 mi가 주어지면 ∀i ∈ [ N], 여기서 [N]은 1에서 N까지의 정수입니다. 각각은 메모리 항목을 나타냅니다. 쿼리 세트 z ∈ RC가 주어지면 메모리 네트워크는 ?z를 얻고 다음과 같이 소프트 주소 벡터 w ∈ R1×N으로 응답합니다. 다음과 같습니다.

여기서 w는 행 벡터이고 모든 항목의 합은 1이며, 이는 i의 항목 w인 wi를 나타냅니다. (e 가중치 벡터 w는 z 계산으로 얻을 수 있습니다. 식 (4)에서 보듯이 주소 가중치는 메모리 모듈 w에 가까워야 합니다. (e 혼합 매개변수는 메모리 모듈의 최대 용량인 N으로 정의됩니다. N이지만 서로 다른 데이터셋에서 최적을 찾기가 쉽지 않은데 다행스럽게도 Memory AE는 N의 설정에 민감하지 않습니다.
2.2.2. 메모리 주소 지정에 주의하십시오. 메모리 AE에서 메모리 모듈은 훈련 단계의 원래 일반 모드 M을 자세히 기록하도록 설계되었습니다. (e 메모리 모듈은 content addressable memory z⌢ 로 정의되며 어드레싱 방식은 쿼리와 메모리 항목의 유사도를 기반으로 어텐션 가중치 w를 계산합니다. 그림 1에서와 같이 각 가중치는 다음을 통해 계산할 수 있습니다. softmax 작업 wi :

여기서 d(·, ·)는 유사성 측정을 나타냅니다. (종이는 그것을 코사인 유사성으로 정의합니다.

방정식 (4)~(6)과 마찬가지로 메모리 모듈은 z의 표현을 얻기 위해 가장 유사한 메모리 항목을 검색합니다. 메모리 크기 및 희소 주소 지정 기술의 한계로 인해 한 번에 적은 수의 내부 메모리 항목만 주소 지정될 수 있습니다. (따라서 메모리 모듈의 효과적인 동작은 다음과 같이 설명할 수 있습니다. 훈련 단계에서 메모리 AE의 디코더는 메모리 항목의 효과적인 사용을 요구하는 재구성을 위해 주소 지정 가능한 메모리 항목을 거의 사용하지 않도록 제한됩니다. (따라서 , 재구성하는 동안 메모리 모듈은 입력된 일반 모드에서 가장 대표적인 프로토타입 모드를 강제로 기록해야 합니다.테스트 단계에서는 훈련된 메모리가 주어지면 메모리의 일반 모드만 재구성을 위해 검색할 수 있습니다.(따라서 , 정상 샘플이 더 잘 재구성될 수 있으며, 반대로 비정상 입력의 코딩된 값이 검색된 정상 패턴으로 대체될 수 있으므로 비정상 샘플에서 큰 재구성 오류가 발생합니다.
2.3. 훈련. 샘플 xi를 포함하는 데이터 세트가 주어졌습니까? ΔTI�1, xi′는 트레이닝 샘플에서 xi의 재구성 샘플을 나타냅니다. 최소 리팩토링은 다음과 같이 수행됩니다.

(e l2 norm은 재구성 오류를 측정하는 데 사용됩니다. wi'는 각 샘플 xi의 메모리 주소 지정 가중치를 나타냅니다. w'의 희소성을 더욱 촉진하기 위해 훈련 중에 희소 정규화가 최소화됩니다. 모든 w'가 음수가 아님을 고려하면 및 ‖w'‖1 � 1, 최적화 문제는 다음과 같이 형성됩니다.

수학식 7의 손실 함수와 수학식 8을 결합하면 Memory AE의 목적 함수는 다음과 같습니다.

다음은 훈련 과정의 하이퍼파라미터입니다. 실제로는 0.0002로 설정됩니다. 학습 과정에서 메모리는 역전파 및 경사하강법을 통해 업데이트됩니다. 역전파에서는 주소 지정 가중치가 0이 아닌 메모리 항목의 그래디언트만 0이 아닐 수 있습니다.
2.4. 시험. 모델이 훈련된 후 치아 프레임 t의 위치(x, y)에서 픽셀의 재구성 오류는 다음 방정식으로 계산할 수 있습니다.

여기서 h(·)는 전체 모델을 나타냅니다. 열 번째 프레임의 픽셀 수준 재구성 오류가 주어지면 이미지 전체 프레임의 재구성 오류는 e(t) 를 합산하여 얻을 수 있습니다. (x,y)e(x,y,t). (en, 프레임의 이상 점수는 다음과 같이 계산할 수 있습니다.

마지막으로 임계값을 설정하여 s(t) > θ로 비정상 여부를 판단할 수 있습니다.
3. 실험
본 절에서는 제안하는 방법의 유효성을 검증하고 기존의 다른 방법과 비교한다. 현재 두 개의 공개 데이터 세트, 즉 Avenue 데이터 세트와 ShanghaiTech 데이터 세트가 실험에 사용됩니다. (e frame level area under the curve(AUC) 및 EER은 정량적 평가 지표로 사용됩니다.
3.1. 준비. (e Avenue 데이터셋은 640 × 360픽셀 해상도의 고정 카메라를 사용하여 홍콩 시립대학교의 거리 활동을 캡처하고 기록합니다. (e 데이터셋 Computational Intelligence and Neuroscience 3에는 정상적인 인간 행동을 포함하는 16개의 교육 비디오 클립과 비정상적인 사건과 인간 행동을 포함하는 테스트 비디오 클립은 총 30652개의 프레임을 가지고 있으며 모든 테스트 비디오에는 목표 수준의 주석이 있습니다. 비정상 이벤트는 사람들이 물건을 버리는/버리는 것, 돌아다니는 것, 카메라를 향해 걷는 것, 잔디 위를 걷는 것, 물건을 버리는 것입니다.(e ShanghaiTech 데이터 세트는 비정상적인 이벤트 감지를 위한 매우 어려운 컬렉션입니다. 다른 데이터 세트와 달리 13개의 서로 다른 데이터 세트가 포함되어 있습니다. 총 330개의 훈련 비디오와 107개의 테스트 비디오를 포함하여 조명 조건과 카메라 각도가 다른 장면. (e 전체 데이터 세트는 훈련 세트의 274515 프레임, 테스트 세트의 42883 프레임, 비정상 프레임의 17090 프레임을 포함하여 총 316154 프레임입니다. (e 각 비디오 프레임의 해상도는 480 × 856입니다. (e 모델은 NVIDIA GTX1080TI 하드웨어 플랫폼과 8GB 비디오 메모리를 탑재한 플랫폼에서 테스트하였으며, 소프트웨어 환경은 PyTorch와 Python 3.6이다. 평가지표는 ROC(Receiver Operating Characteristic Curve)를 사용하며, 프레임별 평가지표는 프레임의 한 픽셀 이상이 비정상으로 표시되면 해당 프레임을 비정상으로 판단하고, 프레임별 AUC는 실제 레이블의 프레임 수준으로 프레임 수준 감지 결과.
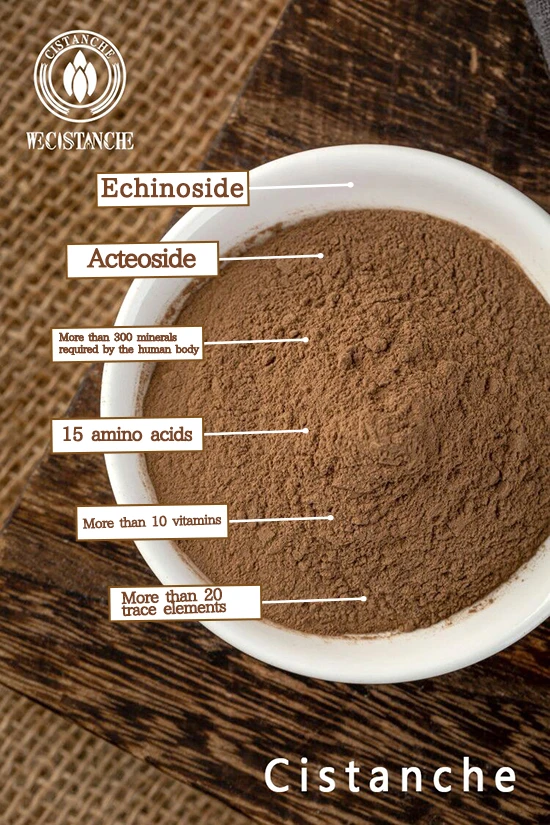
Cistanche deserticola의 주요 화학 성분
【추가 문의】 이메일:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
3.2. 실험 설정. 모든 비디오 프레임은 227 × 227로 조정된 다음 그레이스케일 이미지로 변환됩니다. (모델의 e 입력은 227×227×5, 즉 5개의 연속 프레임을 모델의 입력으로 사용한다. 각 컨볼루션 레이어 뒤에는 배치 정규화 레이어와 ReLU 여기 레이어가 있다. (e 디코더 4개의 디콘볼루션 레이어를 포함합니다.(eattention 모듈은 각 메모리 세그먼트가 비디오 세그먼트의 하위 영역에 해당하는 기능 맵의 픽셀에 기능을 기록하도록 설정됩니다.(따라서 메모리 모듈은 10 00 × 64 행렬. (e Adam 최적화는 전체 모델 매개변수의 최적화를 위해 선택됩니다. (e 초기 학습률은 0.0001이고 반복 횟수는 1000입니다. (e 운동량 매개변수는 ρ1 � 0.9 및 ρ2 � 0.999이고 배치 크기는 128입니다.
3.3. 실험 결과. 제안하는 방법의 비디오 이상 탐지에 대한 유효성을 증명하기 위해 본 논문에서는 이를 기존의 12가지 방법과 비교한다. 그 중 MPPCA(hybrid of probabilistic principal component analyzer)와 SF(social power)[17] 및 MDT(hybrid of dynamic texture)[18]는 수동 기능을 기반으로 하는 방법입니다. Conv-AE[8], 3D Conv[19], Stacked RNN[20] 및 ConvLSTM-AE[21], MemNormality[10] 및 ClusterAE[22]는 모두 자동 인코더를 기반으로 하는 방법입니다. AbnormalGAN [7] 및 Pred plus Recon [23]은 적대적 네트워크 생성 방법을 기반으로 합니다. 표 1은 다양한 방법의 프레임 수준 비디오 이상 탐지 결과를 보여줍니다. 두 데이터 세트의 결과에서 일반적으로 AE 기반 방법이 수제 기능 기반 방법보다 우수하고 더 높은 프레임 수준의 AUC가 얻어지는 것을 관찰할 수 있습니다. (수작업 기능은 일반적으로 다른 작업을 기반으로 추출되기 때문에 차선책일 수 있습니다. AE 기반 방법에서는 전자가 시간 정보를 더 잘 캡처할 수 있기 때문에 ConvLSTM-AE가 Conv-AE보다 낫습니다. GAN 기반 방법은 대부분의 기본 방법보다 성능이 우수합니다.마지막으로 본 논문에서 제안하는 Memory AE 방법은 Avenue 데이터 세트에서 85.7%의 프레임 수준 AUC를 달성하며, 이는 최고 성능의 Pred plus Recon보다 0.6% 앞서 있습니다. [23] 방법; 본 논문에서 제안한 방법은 ShanghaiTech 데이터셋에서 75.3%의 프레임 수준 AUC를 달성했는데, 이는 프레임 수준 AUC에서 다른 방법보다 2% 앞서고 그 효과가 매우 분명하기 때문이다. Memory AE를 기반으로 제안된 방법은 이상 징후를 잘 재구성하고 임의의 오류를 도입할 수 있는 메모리 조각을 사용합니다. 이전에 다른 데이터 세트에 나타나지 않은 여러 장면과 비정상적인 이벤트는 더 복잡합니다. ShanghaiTech 데이터 세트에서 단일 장면의 감지 결과를 확인하기 위해 단일 장면 비디오 세그먼트가 교육 및 테스트에 사용됩니다. 83개 세그먼트(25%)는 교육에 사용되고 34개 세그먼트(32%)는 테스트에 사용되어 86.3% 프레임 수준 AUC를 달성하여 Avenue 데이터 세트와 유사한 수준에 도달했습니다. 요약하면, 제안된 메모리 AE 방법은 다양한 유형의 데이터에 유연하게 적용될 수 있다. 재구성 오차를 이용해야만 제안하는 방법이 최소한의 특정 지식으로 더 나은 결과를 얻을 수 있다. 비정상 영상 이벤트 감지 시 미리 정의된 메모리 모듈의 성능을 평가하기 위해 다음 단계는 메모리 모듈의 크기를 변경하고 Avenue 데이터 세트에 대한 실험을 수행하는 것이며 프레임 레벨 AUC 값은 표 2와 같다. 충분히 큰 메모리 모듈 크기가 주어지면 Memory AE 방식이 견고하게 최상의 결과를 낼 수 있음을 알 수 있습니다. 메모리 모듈의 크기가 1000보다 큰 경우 감지 결과에 미치는 영향은 적지만 더 큰 메모리 모듈 크기를 사용하면 더 많은 계산량이 발생하므로 메모리 모듈 크기는 1000으로 선택됩니다. 그림 2(a) 및 2(b)는 각각 Avenue 데이터 세트 및 ShanghaiTech 데이터 세트에서 몇 가지 탐지 결과를 보여줍니다. (e 표 1: AUC 측면에서 최첨단 방법과의 비교.

핸드메이드 피처를 기반으로 한 방법보다 우수하며, 프레임 수준에서 더 높은 AUC를 얻을 수 있습니다. (수작업 기능은 일반적으로 다른 작업을 기반으로 추출되기 때문에 차선책일 수 있습니다. AE 기반 방법에서는 전자가 시간 정보를 더 잘 캡처할 수 있기 때문에 ConvLSTM-AE가 Conv-AE보다 낫습니다. GAN 기반 방법은 대부분의 기본 방법보다 성능이 우수합니다.마지막으로 본 논문에서 제안한 Memory AE 방법은 Avenue 데이터 세트에서 85.7%의 프레임 수준 AUC를 달성했으며 이는 0.6% 앞선 것입니다. Pred plus Recon [23] 방법 중 가장 성능이 좋은 반면, 본 논문에서 제안한 방법은 ShanghaiTech 데이터 세트에서 75.3%의 프레임 수준 AUC를 달성했으며 이는 프레임 수준 AUC에서 다른 방법보다 2% 앞서고 그 효과는 매우 분명합니다. .(주로 Memory AE를 기반으로 제안된 방법이 메모리 조각을 사용하기 때문에 이상 징후를 잘 재구성할 수 있고 일부 무작위 오류가 발생할 수 있습니다. 또한 Avenue 데이터 세트와 비교하여 ShanghaiTech 데이터 세트는 더 높은 프레임 레벨 AUC를 달성했습니다.(is 주로 ShanghaiTech 데이터 세트에는 이전에 다른 데이터 세트에 나타나지 않은 여러 장면과 비정상적인 이벤트가 포함되어 있어 더 복잡하기 때문입니다. ShanghaiTech 데이터 세트에서 단일 장면의 감지 결과를 확인하기 위해 단일 장면 비디오 세그먼트가 교육 및 테스트에 사용됩니다. 83개 세그먼트(25%)가 교육에 사용되고 34개 세그먼트(32%)가 테스트에 사용되어 86.3% 프레임 수준 AUC를 달성하여 Avenue 데이터 세트와 유사한 수준에 도달했습니다. 요약하면, 제안된 메모리 AE 방법은 다양한 유형의 데이터에 유연하게 적용될 수 있다. 재구성 오차를 이용해야만 제안하는 방법이 최소한의 특정 지식으로 더 나은 결과를 얻을 수 있다. 비정상 영상 이벤트 감지 시 미리 정의된 메모리 모듈의 성능을 평가하기 위해 다음 단계는 메모리 모듈의 크기를 변경하고 Avenue 데이터 세트에 대한 실험을 수행하는 것이며 프레임 레벨 AUC 값은 표 2와 같다. 충분히 큰 메모리 모듈 크기가 주어지면 Memory AE 방식이 견고하게 최상의 결과를 낼 수 있음을 알 수 있습니다. 메모리 모듈의 크기가 1000보다 큰 경우 감지 결과에 미치는 영향은 적지만 더 큰 메모리 모듈 크기를 사용하면 더 많은 계산량이 발생하므로 메모리 모듈 크기는 1000으로 선택됩니다. 그림 2(a) 및 2(b)는 각각 Avenue 데이터 세트 및 ShanghaiTech 데이터 세트에서 몇 가지 탐지 결과를 보여줍니다. (녹색 박스 안의 프레임은 일반 영상의 정상 프레임이고, 빨간 박스 안의 프레임은 비정상 영상의 비정상 프레임입니다. 색종이 떨어뜨리기, 보도에서 자전거 타기, 구타 등 일부 비정상적인 이벤트는 감지됩니다.
표 2: (e Avenue 데이터 세트의 실험 결과에 대한 메모리 크기의 수의 영향(프레임 수준 AUC/퍼센트).

그림 2: 감지 결과의 예. (a) 애비뉴 데이터세트의 예. (b) ShanghaiTech 데이터 세트의 예.

4. 결론
(동영상에서 빅 데이터 이상 탐지 성능을 향상시키기 위해 메모리 AE를 제안한 논문입니다. 제안된 메모리 AE 방법은 입력이 주어지면 먼저 인코더를 사용하여 코딩된 표현을 얻은 다음 코드를 쿼리로 사용하여 가장 관련성이 높은 것을 검색합니다. 메모리 모듈은 전형적인 정상 패턴을 기록하도록 훈련되었기 때문에 제안하는 Memory AE는 정상 샘플을 잘 재구성할 수 있고 이상에 대한 재구성 오류를 확대할 수 있어 이상 감지 기준으로서 재구성 오류의 역할을 강화한다. 2개의 데이터셋에 대한 실험을 통해 제안한 방법의 다양성과 효율성을 입증하였으며, 향후 이상 탐지를 위한 어드레싱 가중치의 활용에 대해 연구할 예정이다. 디코더, 그것은 더 복잡한 기본 모델에 통합되고 더 까다로운 데이터 세트에 대한 실험에 사용됩니다.
Me-Improving Memory 근처의 Cistanche 보충제
참조
[1] F. Dong, Y. Zhang, X. Nie, "비디오 이상 감지를 위한 이중 판별 생성 적대적 네트워크" IEEE Access, vol. 8, pp. 88170–88176, 2020.
[2] K. Doshi 및 Y. Yilmaz, "감시 비디오의 모든 샷 순차 변칙 탐지", CVPRW 회보, pp. 934-935, 미국 워싱턴주 시애틀, 2020년 6월.
[3] K. Doshi 및 Y. Yilmaz, "감시 비디오에서 이상 탐지를 위한 지속적인 학습", CVPRW 절차, pp. 254-255, 미국 워싱턴주 시애틀, 2020년 6월.
[4] K. Jayanta, "Dutta and bonny Banerjee. 증분 코딩 길이를 사용한 비정상적인 이벤트의 온라인 감지", AAAI 회보, pp. 3755–3761, 미국 텍사스주 오스틴, 2015년 1월.
[5] Y. Feng, Y. Yuan, X. Lu, "군중 이상 징후 감지를 위한 심층 이벤트 모델 학습", Neurocomputing, vol. 219, pp. 548–556, 2017.
[6] D. Gong, L. Liu, V. Le et al., "Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection," in the Proceedings of the ICCV, pp. 1705–1714, 서울, 한국, 2019년 10월.
[7] M. Ravanbakhsh, M. Nabi, E. Sangineto, L. Marcenaro, C. Regazzoni 및 N. Sebe, "생성적 적대적 네트워크를 사용하여 비디오에서 비정상적인 이벤트 감지", 이미지 처리에 관한 IEEE 국제 회의 진행 , pp. 1577–1581, 중국 베이징, 2017년 9월.
[8] M. Hasan, J. Choi, J. Neumann, AK Roy-Chowdhury 및 LS Davis, "비디오 시퀀스의 시간적 규칙성 학습", 컴퓨터 비전 및 패턴 인식에 관한 IEEE 회의 진행, pp. 733– 742, 미국 네바다주 라스베이거스, 2016년 6월.
[9] W. Liu, W. Luo, D. Lian 및 S. Gao, "이상 감지를 위한 미래 프레임 예측 - 새로운 기준선", 컴퓨터 비전 및 패턴 인식에 관한 IEEE 회의 절차, pp. 6536– 6545, 미국 유타주 솔트레이크시티, 2018년 6월.
[10] H. Park, J. Noh, and B. Ham, "Learning memory-guided normality for anomaly detection," in the IEEE Conference on the Computer Vision and Pattern Recognition, pp. 14 372–{{ 3}}, 미국 워싱턴주 시애틀, 2020년 6월.
[11] MZ Zaheer, J.-h. Lee, M. Astrid, and S.-I. Lee, "Old is gold: redefining the adversarially learning one-class classifier training paradigm," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pp. 14 183–214 193, Seattle, WA, 미국, 2020년 6월.
[12] X. Zhu, J. Liu, J. Wang, Y. Fang 및 H. Lu, "모양 및 역학 결합 모델링을 통한 혼잡한 장면에서의 이상 감지", 이미지 처리에 관한 IEEE 국제 회의 진행, 2705–2708, Melbourne, VIC, Australia, 2013년 9월.
[13] RVHM Colque, CAC J´unior 및 WR Schwartz, "비디오에서 변칙적인 사건을 감지하기 위한 광학 동료 방향 및 크기의 히스토그램", 그래픽, 패턴 및 이미지에 관한 Sibgrapi 회의 진행, pp. 126–133 , 살바도르, 바이아, 브라질, 2015년 8월.
[14] Bo Zong, S. Qi, RM Martin 등, "감독되지 않은 이상 탐지를 위한 심층 자동 인코딩 가우시안 혼합 모델", 학습 표현에 관한 국제 회의 진행, 캐나다 밴쿠버, 2018년 4월.
[15] M. Sabokrou, M. Fayyaz, M. Fathy, Z. Moayed 및 R. Klette, "심층 이상: 붐비는 장면에서 빠른 이상 감지를 위한 완전 컨벌루션 신경망", Computer Vision and Image Understanding, vol. 172, pp. 88–97, 2018.
[16] C. Li, Z. Han, Q. Ye, J. Jiao, "궤적 희소 재구성 분석에 기반한 시각적 이상 행동 탐지", Neurocomputing, vol. 119, 아니오. 7, pp. 94–100, 2013.
[17] V. Mahadevan, W. Li, V. Bhalodia 및 N. Vasconcelos, 컴퓨터 비전 및 패턴 인식(CVPR)에 관한 IEEE 회의 절차, pp. 1975–1981, IEEE, 샌프란시스코, 캘리포니아, 미국, 2010년 6월.
[18] W. Li, V. Mahadevan 및 N. Vasconcelos, "붐비는 장면에서 이상 감지 및 위치 파악" 패턴 분석 및 머신 인텔리전스에 관한 IEEE 트랜잭션, vol. 36, pp. 18–32, 2014.
[19] Y. Zhao, B. Deng, C. Shen, Y. Liu, H. Lu 및 X.-S. Hua, "비디오 이상 감지를 위한 시공간 AutoEncoder", ACM International Conference on Multimedia(ACM MM) 회보, pp. 1933–1941, ACM, Mountain View California USA, 2017년 10월.
[20] W. Luo, L. Wen, S. Gao, "A revisit of sparse coding based anomaly detection in stacked RNN framework," in the IEEE International Conference on Computer Vision (ICCV), 베니스, 이탈리아, 10월 2017.
[21] W. Luo, L. Wen, S. Gao, "이상 탐지를 위한 컨벌루션 LSTM을 사용한 기록 기억하기", IEEE International Conference on Multimedia and Expo(ICME), pp. 439–444, IEEE, 홍콩, 2017년 7월.
[22] Y. Chang, Z. Tu, W. Xie 및 J. Yuan, "비디오 이상 감지를 위한 클러스터링 기반 딥 오토인코더", 유럽 컴퓨터 비전 회의(ECCV) 절차, pp. 329–345, Springer, 글래스고, 영국, 2020년 8월.
[23] L. Wen, W. Luo, D. Lian 및 S. Gao, "Future frame prediction for anomaly detection – a new baseline", IEEE Conference on Computer Vision and Pattern Recognition (CVPR), pp . 6536–6545, IEEE, 미국 유타주 솔트레이크시티, 2018년 6월.
[24] M. Song, "A mean field view of the landscape of two-layer neural networks," Proceedings of the National Academy of Sciences, vol. 115, 아니. 33, pp. E7665–E7671, 2018.
[25] B. Ding 및 G. Wen, "SAR 이미지의 표적 인식을 위한 하위 공간 분류기에서 가장 가까운 희소성 제약", Journal of Visual Communication and Image Representation, vol. 52, pp. 170–176, 2018.
[26] T. Wang 및 H. Snoussi, "전역 광학 동료 방향 히스토그램을 통한 비정상적인 시각적 이벤트 감지", 정보 포렌식 및 보안에 관한 IEEE 트랜잭션, vol. 9, 아니오. 6, pp. 988–998, 2014.