전자상거래 리뷰의 효율적인 장단기 메모리 기반 감성 분석 3편
Jan 18, 2024
4. 결과
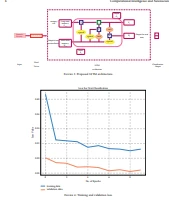
우리는 약 10세대 동안 모델을 훈련하고 훈련 및 검증 정확도뿐만 아니라 훈련 및 검증 손실도 계산했습니다.
상실은 우리 삶에서 피할 수 없는 사건처럼 보일 수 있지만, 그것이 우리의 정신 건강과 기억에 미치는 영향은 엄청날 수 있습니다.
첫째, 상실을 경험할 때 부정적인 감정에 사로잡히기 쉽습니다. 여기에는 슬픔, 분노, 불안 등이 포함될 수 있습니다. 이러한 감정은 우리의 정신 건강에 영향을 미쳐 우리를 지치고, 무력하고, 실망하게 만들 수 있습니다. 동시에, 이러한 부정적인 감정은 우리의 기억에도 영향을 미쳐 집중을 어렵게 만들고 기억력이 흐려질 수 있습니다.

그러나 상실을 경험할 때에도 우리는 여전히 긍정적인 태도와 낙관적인 관점을 유지하여 부정적인 감정이 정신 건강과 기억에 미치는 영향을 극복하는 데 도움을 줄 수 있습니다. 여기에는 무엇보다도 친구 및 가족과 함께 시간을 보내고, 감정을 공유하고, 건강한 식습관과 생활 방식을 유지하고, 신체 운동에 참여하고, 심리 치료에 참여하는 것이 포함됩니다.
또한, 상실 과정에서 좋은 기억을 유지하기 위해 적극적인 조치를 취할 수 있습니다. 여기에는 새로운 상황을 받아들이고 적응할 수 있는 시간을 주는 것뿐만 아니라 기억 연상 구축, 연습 반복, 메모리 스틱 사용 등과 같은 새로운 기억 기술 및 전략을 시도하는 것도 포함됩니다.
대체로 상실은 우리의 정신 건강과 기억력에 큰 타격을 주지만, 우리는 이러한 영향을 극복하기 위해 적극적인 조치를 취할 수 있습니다. 긍정적인 태도를 유지하고 새로운 상황에 적응할 시간을 가질 수 있다면, 우리는 더 쉽게 정신 건강과 기억을 되찾고 더 나은 삶으로 다시 나아갈 수 있을 것입니다. 기억력 향상이 필요함을 알 수 있는데, 시스탄체 데저티콜라는 기억력 향상이라는 독특한 효능이 많은 중국 전통 약재이기 때문에 기억력을 크게 향상시킬 수 있습니다. 다진 고기의 효능은 산, 다당류, 플라보노이드 등 포함된 다양한 활성 성분에서 비롯됩니다. 이러한 성분은 다양한 방식으로 뇌 건강을 증진할 수 있습니다.
그림 4에서 모델 훈련 전반에 걸쳐 훈련 손실과 검증 손실이 모두 감소한 것을 볼 수 있습니다. 그림 5는 10세대 동안 훈련 및 검증 정확도가 이후에 증가했음을 보여줍니다.
예측 후 우리가 얻는 최종 출력은 확률이므로 특정 임계값을 적용하여 데이터가 양성 클래스에 속하는지 음성 클래스에 속하는지 여부를 결정합니다. 이를 위해 우리는 진양성 비율과 음성 비율을 표시하는 ROC 곡선을 사용했습니다.
이진 분류자의 임계값을 찾는 데 도움이 됩니다. 그림 6에 표시된 ROC 곡선에서 0.78을 임계값으로 선택했습니다.
+e 저장된 모델이 다시 로드되고 위에서 언급한 임계값을 고려하여 테스트 데이터에 대한 예측이 생성되었습니다. 이제 우리는 원래의 감정과 예측된 감정을 갖게 되었습니다.
데이터 세트가 불균형하기 때문에 모델을 테스트하는 데 더 좋은 매개 변수는 정확도보다는 F1 점수입니다.
Table 4에서는 다른 기준 모델의 정확도, 정밀도, 재현율, F1 점수를 정리하여 우리 모델과 비교했습니다. +e 기본 모델은 이 실험을 위해 검토한 문헌에서 고려되었습니다.

5. 결론+전자상거래 리뷰의 맥락에서 감정 분석을 논의한 논문입니다. 이전에 리뷰의 의견 마이닝 분야에서 다양한 기술이 조사되었습니다.
우리 데이터베이스는 Amazon 휴대폰 및 액세서리 섹션의 리뷰로 구성되어 있습니다. 딥러닝을 통해 감정을 분류하기 위해 Long Short-Term Memory Networks를 사용했습니다. 우리의 맞춤형 교육 데이터 세트는 word2vec 임베딩 기술에 포함된 기능을 추출하는 데 사용되었습니다. ROC 곡선을 기반으로 우리는 0.78이 감정 분류에 사용해야 하는 최종 임계값임을 결정했습니다.
모델 성능을 평가하기 위해 정확도, 정밀도, 재현율, F1 점수 등 4가지 매개변수가 사용되었습니다. 97%의 정밀도는 4개 매개변수 중 가장 높은 것으로 나타났습니다.

데이터 세트가 불균형하기 때문에 F1score를 모델 성능의 가장 좋은 측정값으로 간주하여 93%의 평가를 산출합니다. 본 연구의 주요 시도는 많은 양의 데이터를 사용하여 모델의 기능을 테스트하는 것이었습니다. +is 방식은 약 938,261건의 리뷰라는 대용량 데이터에도 좋은 결과를 제공합니다. +e 이 방법을 사용하는 주요 이점은 LSTM이 효율적인 감정 분석에 도움이 되는 장기 기억 및 word2vec 효율적인 단어 표현 추정을 고려한다는 것입니다.
향후 작업을 위해 우리는 실제 입력 시퀀스와 역방향 LSTM의 두 가닥을 훈련하는 감정 분류를 위해 양방향 LSTM을 사용하는 것을 고려하고 싶습니다. +is는 모델 성능을 향상시키는 데 도움이 될 수 있습니다.
데이터 가용성
+e 이 연구 결과를 뒷받침하는 데 사용된 데이터는 요청 시 해당 작성자에게 제공됩니다.
이해 상충
+e 저자는 이해상충이 없음을 선언합니다.
감사의 말
+이 연구는 Princess Nourah bint Abdulrahman 대학 연구원 지원 프로젝트 번호(PNURSP2022R120), Princess Nourah bint AbdulrahmanUniversity, Riyadh, Saudi Arabia의 지원을 받았습니다.

참고자료
[1] B. Liu, 감정 분석: 마이닝 의견, 감정 및 감정, Cambridge Univ. Press, 뉴욕, 뉴욕, 미국, 1stdition, 2015.
[2] P. Balaji, O. Nagaraju 및 D. Haritha, "3월) 감정 분석 수준 및 과제: 문헌 검토, 빅 데이터 분석 및 전산 지능에 관한 국제 회의(ICBDAC) 회의록, pp. 436–439, IEEE, 인도 키랄라, 2017년 3월.
[3] R. Varghese 및 M. Jayasree, "감정 분석 및 의견 마이닝에 대한 조사", 국제 재생에너지 기술 저널, vol. 2, 아니. 11, pp. 312–317, 2013.
[4] C. Sindhu 및 DS Chandrakala, "의견 마이닝 및 정서 극성 분류에 대한 조사", International Journal of Emerging Technology and Advanced Engineering,vol. 3, pp. 531–539, 2013.
[5] A. Jurek, Mulvenna 및 Y. Bi, "소셜 미디어 분석을 위한 향상된 어휘 기반 감정 분석", Security Informatics, vol. 4, 아니. 1, p. 2015년 9월 9일
[6] S. Zhang, D. Zhang, H. Zhong 및 G. Wang, "전자상거래 리뷰에 대한 감정의 다중 분류 모델", IEEE Access, vol. 8, 페이지 189513–189526, 2020.
[7] J. Devlin, M. Chang, K. Lee 및 K. Toutanova, "BERT: 언어 이해를 위한 심층 양방향 변환기의 사전 훈련", 북미 챕터 협회 전산 언어학, 인간 언어 기술 컨퍼런스 회보, pp. 4171 –4186, 미네소타 주 미니애폴리스, 2019년 6월.
[8] L. Dey, S. Chakraborty, A. Biswas, B. Bose 및 S. Tiwari, "Naive Bayes 및 k-nn 분류기를 사용한 리뷰 데이터 세트의 감정 분석", 2016,https://arxiv.org/abs/1610.09982.
[9] MR Huq, A. Ali 및 A. Rahman, "KNN 및 SVM을 사용한 트위터 데이터에 대한 감정 분석", 고급 컴퓨터 과학 및 응용 분야의 국제 저널, vol. 8, 아니. 6,pp. 2017년 19~25일.
[10] BS Lakshmi, PS Raj, RR Vikram, "KMeans를 이용한 딥러닝 기법인 CNN을 이용한 감성 분석," International Journal of Pure and Applied Mathematics, vol. 114, 아니. 11, 47~57페이지, 2017.
[11] Y. Fang, H. Tan, J. Zhang, "의미적 모호성에 기반한 소비자 리뷰의 다중 전략 감정 분석", IEEE Access, vol. 6, 20625~20631페이지, 2018년.
[12] B. Shin, T. Lee, JD Choi, "Lexicon은 정서 분석에 주목하여 CNN 모델을 통합했습니다.", 2016,https://arxiv.org/abs/1610.06272입니다.
For more information:1950477648nn@gmail.com