컨볼루션 신경망과 시간 신호 특성을 사용한 Dce-Mr 이미지의 건강한 신장 분할
Mar 23, 2022
아르투르 클레파츠코1, 엘리 아이케피요르드2아비드 룬더볼드2,3,4
추상적인:동적 조영증강 자기공명영상(DCE-MRI)을 기반으로 한 신장 관류의 정량화는 신장 실질 영역에서 신호 강도 시간 과정의 결정을 필요로 합니다. 따라서 다음을 나타내는 복셀을 선택합니다.신장특별한 주의를 기울여 수행해야 하며 표준 임상 루틴으로 이 기술의 광범위한 사용을 방해하는 주요 기술적 한계 중 하나를 구성합니다. 신장 구획의 수동 분할은 전문가가 수행하더라도 반복성과 재현성이 감소하는 일반적인 원인입니다. 이 논문에서는 자동 처리 프레임워크를 제시합니다.신장DCE-MR 이미지의 분할. 프레임워크는 두 단계로 구성됩니다. 첫째,신장마스크는 컨볼루션 신경망을 사용하여 생성됩니다. 그런 다음 마스크 복셀은 DCE-MRI 신호 강도 시간 과정에 따라 피질, 수질 및 골반의 세 영역 중 하나로 분류됩니다. 제안된 접근법은 DCE-MRI 검사를 받은 10명의 건강한 지원자 코호트에서 평가되었습니다. 10-일 간격 내에서 2회 이벤트에 대해 MRI 스캔을 반복했습니다. 의미론적 분할 작업을 위해 우리는 고전적인 U-Net 아키텍처를 사용했지만 복셀 분류에 대한 실험은 지원 벡터 머신, 로지스틱 회귀 및 극한 그래디언트 부스팅 트리의 세 가지 대체 알고리즘을 사용하여 수행되었으며 그 중 SVM이 가장 정확한 결과를 생성했습니다. 분할 및 분류 단계는 모두 다른 참가자의 데이터만 사용하여 주어진 주제에 대해 개별적으로 훈련된 일련의 모델에 의해 수행되었습니다. 평균은 전체의 정확도를 달성했습니다.신장세분화는 IoU 계수 측면에서 94%였습니다. 피질, 수질 및 골반은 조직 및 신체 측면에 따라 90~93% 범위의 IoU로 분할되었습니다. 결과는 이미지에서 파생된 관류 매개변수를 실제 측정값과 비교하여 검증되었습니다.사구체 여과율(GFR). 변동 계수로 평가한 GFR 계산의 반복성은 왼쪽 및 오른쪽 신장에 대해 각각 14.5% 및 17.5% 수준에서 결정되었으며 수동 분할에 비해 개선되었습니다. 이미지 파생 GFR 값과 iohexol 기반 GFR 값 간의 일치를 측정하여 재현성을 평가했습니다. 추정된 절대 평균 차이는 스캐닝 세션 1 및 2 및 제안된 자동 분할 방법에 대해 9.4 및 12.9 mL/min/1.73 m2와 동일했습니다. 세션 2의 결과는 수동 세분화와 비슷했지만 세션 1의 경우 자동 파이프라인의 재현성이 약했습니다.
키워드:동적 대비 강화 MRI; 컨볼루션 신경망;신장분할; 약동학 모델링; 관류 정량화; 사구체 여과율
연락처: ali.ma@wecistanche.com

신장 질환에 대한 Cistanche Herba를 클릭하십시오
1. 소개
신장 기능은 혈청 크레아티닌 수치를 측정하여 일상적으로 평가됩니다. 그 가치를 바탕으로,사구체 여과율(GFR)은 예를 들어 신장 질환에서 식이 요법의 수정 방정식[1]을 사용하여 추정할 수 있습니다. 최근 임상에서 인기를 얻고 있는 GFR을 결정하는 또 다른 방법은 iohexol 혈장 청소율 검사입니다. 일부 저자들은 이 방법이 이눌린의 요 청소율에 기반한 금본위제 기술을 대체한다고 가정합니다[2]. 그러나 이러한 모든 절차를 통해 두 가지 모두에 대해 동시에 GFR을 정량화할 수 있습니다.신장. 따라서 동적 대조 강화 자기 공명 영상(DCE-MRI)은 매력적인 대안으로 나타납니다.신장국소 분절 사구체 경화증과 같은 조직 병변에 대한 공간 해석 정보를 제공합니다.
원칙적으로 DCE-MRI 검사는 스캔 절차의 여러 개별 시간 단계에서 획득한 일련의 T{1}가중 볼륨을 생성합니다. 이 방법은 가돌리늄 기반 조영제(CA)의 볼루스(bolus)를 정맥내 투여하는 것으로 구성됩니다. CA bolus가 복부 동맥 나무, 모세 혈관 층 및 관상 시스템을 통과하는 동안신장침투된 조직의 T1 이완 시간을 효과적으로 증가시켜 이미지의 대비를 수정합니다. 이 이미지 신호 강도 변화의 시간적 역학은 신장 기능의 생리학적 조건을 반영하고 신장 관류의 약동학(PK) 모델링의 기초를 구성합니다.
제안된 많은 PK 모델은 다양한 기관에서 혈액 관류 과정을 수학적으로 설명하려고 시도합니다. 에 관해서신장, 대부분의 모델은 주어진 조직 복셀에서 측정된 신호가 혈관내(IV) 및 세포외 혈관외(EEV) 공간의 최소 두 구획에서 비롯된 기여의 합이라고 가정합니다[3-6]. 또한, 각 PK 모델에서와 같이, 섭식 동맥을 통해 관심 기관으로의 가돌리늄 추적자의 전달은 소위 동맥 입력 기능(AIF)에 의해 캡슐화됩니다. 실제로, 신장 연구의 경우 AIF는 복부 대동맥에서 조영제 농도의 시간 경과입니다[7]. AIF를 이동 및 분산 커널로 컨벌루션하여 IV 구획에서 추적자 농도를 얻습니다. 결국, EEV 공간에서 농도의 시간 곡선은 IV 구획의 농도의 적분에 비례하며, 선택적으로 신세뇨관으로부터의 유출을 나타내는 지수 인자에 의해 조절됩니다. 종종 Ktrans로 표시되는 비례 계수는 IV에서 EEV 구획으로의 CA 전달 속도를 제어합니다. Ktrans에 오르간의 부피를 곱하면 GFR 계산으로 직접 연결됩니다.
잠재적인 임상 적용이 의심스럽긴 하지만 더 복잡한 다중 구획 접근법이 존재합니다(예: [8]). 어려움은 모델 곡선을 관찰된 데이터에 맞추면서 그러한 모델 매개변수의 최적화 안정성을 보장할 필요성에 있습니다. 또한, 이러한 모델은 세분화가 필요합니다.신장피질과 수질에 실질. 이 요구 사항은 실제로 두 구획 모델에도 적용됩니다. 일반적인 Rutland-Patlak 모델[9,10]에 기초한 [3]에서 제안한 고전적 모델은 피질 영역에만 적용 가능하다. 한편, 전체 신장에 대한 2구획 여과 모델[5]의 적용은 흡수 단계에 대해 허용됩니다. 관류를 측정하려면 분석을 다시 피질로만 제한해야 합니다. 어쨌든 검사의 배설 단계에서 대조를 수집하는 골반 영역을 제외해야합니다. 따라서 DCE-MRI 데이터 분석 절차를 자동화하려면 신장의 묘사뿐만 아니라 각 신장 복셀을 피질, 수질 또는 골반 클래스에 속하는 것으로 표시해야 합니다.

의 문제신장세분화는 많은 저자에 의해 다루어졌습니다. 흔히 복셀은 강도 시간 과정에 따라 분류됩니다. 예를 들어 [11]에서 k-means 알고리즘은 신호 강도 시간 과정에 따라 복셀을 클러스터로 그룹화하는 데 사용됩니다. 이 접근 방식은 신호 강도 시간 과정이 이산 웨이블릿 변환에 의해 사전 처리된 [12]에서 추가로 개발되었습니다. 결국, 어떤 클러스터가 피질, 수질, 골반 및 배경을 나타내는지를 결정하기 위해 고유한 클러스터 특성과 이들의 관계에 기반한 일종의 휴리스틱을 사용해야 합니다. 완전히 감독되지 않은 추론은 해부학적으로 의미 있는 범주로 명확하게 분류할 수 없는 잡음이 많은 입력 데이터로 인해 어려움을 겪습니다. 피질과 수질 사이의 경계에 있는 복셀과 관련하여 특히 분명합니다. 그것들은 외부에서도 복셀을 포함하는 "기타 부품" 클래스에 할당됩니다.신장.
따라서 자주 따르는 전략은 먼저 전체를 분리하는 것으로 구성됩니다.신장이미지의 다른 부분에서. 묘사된 관심 영역은 모든 이웃 복셀을 제거하기 위해 신장 경계에 정확하게 맞아야 합니다. 이러한 솔루션의 예는 [13]에서 사용된 AUC(area-under-the-curve map)입니다. 추적 에이전트에 의해 침투된 DCE-MRI 시퀀스의 복셀은 신호 강도 시간 과정에서 가장 큰 영역으로 인해 AUC 맵에서 밝게 나타납니다. 이 접근법은 신장 외 구조, 큰 혈관 및 요로 집합관을 제거하기 위해 수동 또는 자동 후처리가 필요하다는 점에 유의하는 것이 좋습니다.
MSTV(Maximally Stable Temporal Volumes) 개념이 도입된 [14]에서도 거친 분할 전략이 적용되었습니다. MSTV 기능을 통해신장공간적으로 균질하고 시간적으로 안정적인 구조를 감지함으로써. 세분화된 세분화는 복셀의 시간 과정을 주성분의 벡터로 줄임으로써 얻은 다음 k-평균에 의해 다중 클러스터로 분할됩니다. 그러나 결과적으로 얻은 분할은 남아 있는 노이즈를 제거하기 위해 반복적으로 개선되어야 합니다. 유사하게 [15]에 기술된 연구에서 분할 절차의 첫 번째 단계는 복부 조직의 신호 강화 역학의 특성화로 구성됩니다. 피질, 간 또는 비장과 달리 수질은 획득 시퀀스에서 나중에 발생하는 신호 강도의 꾸준한 증가를 나타내는 것으로 관찰됩니다. 수질 복셀이 식별된 후 신장 마스크를 생성하기 위해 GrubCut 알고리즘이 뒤따르는 확장이 수행됩니다. 사전 훈련된 랜덤 포레스트 분류기로 복셀을 분류하여 미세 조정을 수행합니다. 복셀은 동적 시퀀스의 선택된 시간 프레임에서 각각의 이미지 강도와 첫 번째 단계에서 구성된 ROI 내의 위치를 특징으로 합니다.
MSTV 기반 및 GrubCut 기반 기여는 모두 여러 데이터 세트에 대해 만족스러운 결과를 생성하는 것처럼 보이지만 개념적으로는 다소 복잡한 알고리즘이며 상용 또는 오픈 소스 소프트웨어에서 사용할 수 없습니다. 따라서 임상 커뮤니티에서 쉽게 채택할 수 없습니다.
반면에, 최근 컨볼루션 신경망 아키텍처의 발전과 소프트웨어 구현의 광범위한 가용성으로 인해 딥 러닝 방법은 의료 이미지의 생물학적 조직 분할에 적용하는 데 특히 매력적입니다. MRI 데이터 분석의 다양한 시나리오에서 CNN의 효과는 [16]의 포괄적인 검토에서 철저히 논의됩니다. 보다 구체적으로, [17] 다양한 네트워크 아키텍처, 즉 완전 컨볼루션 네트워크 [18], SegNet [19], U-Net [20] 및 DeepLabV3 plus [21]에서 T에서 전립선암의 의미론적 분할에 대해 테스트되었습니다. 2-가중 MRI. 해부학적 자기공명영상도 [22]에서 분석하였다. 저자는 다낭성 윤곽을 자동으로 표시하는 맞춤형 CNN 아키텍처를 개발했습니다.신장. 또 다른 흥미로운 접근 방식이 [23]에서 제시되었는데, 여기서 PK 모델을 측정된 신호에 명시적으로 맞추지 않고 DCE-MRI 시퀀스에서 뇌 관류 맵을 직접 추론하기 위해 딥 러닝이 사용되었습니다.
CNN의 세분화에 대한 적용에 대한 여러 발표된 연구가 있었습니다.신장컴퓨터 단층 촬영 이미지에서 [24,25]. 그러나 DL 기반 세분화신장대조 강화 MRI 데이터 세트에서 여전히 고갈되지 않은 주제로 남아 있습니다. 특히 신장 DCE-MRI 검사에 전념하는 출판된 연구의 예외적인 예로서 Haghighi 등의 논문을 언급할 수 있습니다. [26]. 그들은 두 개의 CNN 네트워크의 캐스케이드를 구성하고 훈련했습니다. 이 계단식 구조에 대한 입력은 4D DCE-MR 이미지입니다. 첫 번째 네트워크는 이미지에서 왼쪽 및 오른쪽 신장을 대략적으로 국소화하는 반면, 두 번째 네트워크는 신장 경계의 정확한 묘사를 담당합니다. 그러나 전체 신장 실질만 GFR을 계산하는 데 사용되었기 때문에 피질 또는 수질로의 추가 분할은 수행되지 않았습니다.
위의 고려 사항에 비추어 본 논문에서 제시한 접근 방식은 한쪽에서 정확하게 인식하는 자동 알고리즘의 필요성에 대한 응답입니다.신장DCE-MR 이미지 내의 구획이 있는 반면, 다른 쪽에서는 모든 연구팀이 비교적 쉽게 재현할 수 있습니다. 따라서 다음을 제안합니다.
1. 의미론적 분할을 위해 CNN 아키텍처 사용신장실질,
2. PCA(주성분 분석)에 의한 신호 강도 파형의 변환에서 파생된 기능 집합을 사용하여 실질 복셀을 설명합니다.
3. 추출된 PCA 특징 벡터의 분류를 통해 피질, 수질 및 골반 영역을 구별합니다.
사용된 알고리즘의 세부사항은 섹션 2에 나와 있습니다. 섹션 3에서는 분할 결과와 설계된 솔루션이 추정된 PK 매개변수의 안정성에 어떻게 영향을 미치는지 평가합니다. 이 평가를 수행하는 동안 우리는 또한 과거 데이터에 기초하여 새로운 주제에 대한 정확한 분할을 생성할 수 있는 범용 컴퓨팅 체계를 구성하는 것이 가능하다고 가정합니다. 우리는 그러한 체계가 맞춤형 이미지 획득 프로토콜에 적응하기 위한 노력 없이 또는 거의 전혀 노력 없이 클리닉에서 널리 배포되고 구현될 수 있다고 믿습니다. 이 목표를 달성하기 위해 제안된 계산 프로세스를 하나의 주제에서 벗어나는 방식으로 검증했습니다. 우리는 각각 다른 환자 집단에 대해 훈련된 일련의 세분화 및 분류 엔진을 만들었습니다. 그런 다음 훈련 단계에서 보이지 않는 주제에 대해 주어진 엔진을 테스트했습니다. 얻어진 결과에 대한 논의는 4장에서 다룬다.
2. 재료 및 방법
2.1. MRI 데이터
이 문서에 제시된 실험과 알고리즘은 10명의 건강한 지원자로부터 얻은 2개의{23}} 측정 시퀀스 세트를 사용하여 설계되었습니다. MRI 검사는 1.5 T 장치(Siemens Magnetom Avanto, Erlangen, Germany)에서 수행되었습니다. 데이터 수집 프로토콜은 대비가 강화된 3D 손상 경사 에코 방법(TE/TR/FA=0.8/2.36/20 .ms/ms/-, in- 평면 해상도=2.2 × 2.2 mm2, 슬라이스 두께=3 mm, 획득 행렬=192 × 192, 슬라이스 수=30). 조영제(0.025mmol/kg의 GdDOTA)를 3mL/s의 유속으로 정맥내 투여했습니다. 각 측정 시퀀스는 2.3초 시간 간격으로 획득한 74개의 프레임으로 구성되었습니다.
모션 아티팩트를 줄이기 위해 이미징 프로토콜은 숨을 참을 때 이미지를 획득하도록 설계되었습니다. 먼저, 18-숨 참기 기간 동안 8개의 기준선 조영 전 용적을 획득했습니다. 가돌리늄 주입 후 7초에 참가자들은 움직임이 없는 1차 통과 관류를 위해 26초 동안 숨을 참도록 지시받았습니다. 다음으로, 여과 단계에서 숨 참기 기간을 13초로 단축하고 26초의 자유 호흡으로 인터리브했습니다. 호흡을 용이하게 하기 위해 피험자들은 1 L/min의 유속으로 비강으로 산소를 공급받았다.
남은신장 모션은 각 DCE-MRI 시퀀스에 대해 b-spline 등록을 실행하여 후처리에서 수정되었습니다. 이를 위해 ITK(Insight Toolkit) 소프트웨어 라이브러리[27]의 B-스플라인 알고리즘 구현을 사용했습니다. 모든 시퀀스에서 관류 단계의 중간 지점에 해당하는 참조 프레임을 선택한 다음 다른 모든 (움직이는) 볼륨이 일치하는 고정 볼륨으로 사용했습니다. B-스플라인 등록은 완전히 자동으로 수행되었습니다. 즉, 관심 조직 위에 기준점이 표시되지 않았습니다. 또한 절차는 다단계 구성으로 시작되었습니다. 각 단계에서 그리드 크기와 서브샘플링 비율의 다양한 설정이 사용되었습니다. 이러한 매개변수에 대한 자세한 해석은 ITK 문서를 참조하십시오. 요컨대, 거친 매칭부터 시작하여 결과를 다듬는 등 다양한 규모의 이미지 등록을 수행할 수 있었습니다.
알고리즘 설계 및 평가의 필요성을 위해 MR 요로조영술에 대한 전문 지식을 갖춘 방사선 전문의가 모든 볼륨에 수동으로 주석을 달았습니다. 각 시간 프레임에서 왼쪽과 오른쪽신장묘사되었다. 그런 다음 관류 및 배설 단계와 연결된 두 프레임에서 실질 복셀이 피질, 수질 또는 골반에 할당되었습니다.
시험 사이에 지원자들은 iohexol 제거 절차를 거쳤습니다. 피험자들에게 5mL의 iohexol(300mg I/mL; Omnipaque 300, GE Healthcare)의 용량을 투여했습니다. 그런 다음 이미지에서 파생된 관류 추정치를 검증할 수 있도록 실제 GFR 값을 결정했습니다.
피험자들은 술과 고단백 식사를 거부하고, 과도한 육체 노동을 피하고, 검사 최소 2일 전에 정상적으로 수분을 섭취하고, 검사 당일 카페인을 섭취하지 않도록 지시받았다. 스캐닝 세션과 iohexol 클리어런스 테스트 사이에 유사한 검사 조건을 보장하기 위해 규칙적인 식사 시간과 식단을 유지하는 것이 좋습니다. 모든 자원 봉사자는 노르웨이 Haukeland University Hospital Bergen의 기관 검토 위원회에서 승인한 연구 참여에 대해 서면 동의서를 제공했습니다.
2.2. 세분화 파이프라인 개요
제안된 분할 파이프라인은 그림 1에 시각화되어 있습니다. 초기 거친 분할은 U-Net 구조의 완전 컨볼루션 신경망에 의해 수행됩니다. 이 단계는 DCE-MRI 시퀀스에서 단일 체적 이미지의 후속 2차원 단면에서 수행되었습니다. 이 이미지는 신실질의 피질과 수질로의 분할이 명확하게 보일 때 피질 영역에서 가장 높은 신호 향상 프레임에 해당합니다.

단일 단면이 각각 96-픽셀 너비로 왼쪽과 오른쪽으로 분할될 수 있다고 가정했습니다. 주어진 측면에서 완전히 하나를 덮는 96-픽셀 높이의 이미지 패치를 중앙에서 찾을 수 있습니다.신장. 이런식으로 좌, 우신장세분화되어 별도로 처리됩니다. 현재 우리의 방법은 네트워크 운영의 회수 단계에서 이 가정을 유지해야 했습니다. 훈련하는 동안 이미지 패치에 신장 실질의 적어도 일부가 포함되어 있으면 충분합니다. 또한 96 × 96 패치 크기는 이 연구에서 사용 가능한 DCE-MRI 데이터의 면내 해상도로 조정되었으며 다른 수집 구성에서 수정되어야 합니다.
거친 분할은 때때로 잘못 분할된 픽셀의 작은 신외 클러스터를 거부하기 위해 추가 미세 조정이 필요할 수 있습니다. 우리 알고리즘에서는 연결된 구성 요소를 식별하고 가장 큰 구성 요소만 다음 단계로 전달합니다. 또한 의미론적 분할 단계는 2D로 수행되었지만 주어진 볼륨의 모든 단면에 적용되었습니다. 다음으로 수행된 분석은 3D 피질 ROI에 분포된 모든 네프론에서 효과적으로 GFR을 계산할 수 있도록 복셀 방식으로 수행되었습니다.
시간 영역에서 이미지 등록 덕분에,신장한 프레임에 대해 생성된 마스크는 동적 시리즈의 다른 모든 프레임에 적용될 수 있습니다. 따라서, 신장 복셀은 후속 시점에서 측정된 MRI 신호 강도 값으로 구성된 특징 벡터를 처방하였다. 신호 역학의 보다 일반적인 특성을 얻기 위해 PCA 변환을 사용하여 특징 집합체를 추출했습니다. 가장 유익한 20개의 집계가 각 신장 복셀을 설명하기 위해 선택되었습니다. 결국 분류기는 피질, 수질 및 골반 영역의 시간적 특성을 구별하도록 훈련되어 복셀을 적절한 범주에 할당했습니다.
제안된 2단계 접근 방식 뒤에 있는 이론적 근거는 최종 인식이 최대한으로 자신감 있는 실측 주석을 기반으로 하도록 하는 것이었습니다. CNN이 수질과 골반에서 피질을 분리하는 경우 정확한 타겟 마스크가 생성되어야 하고 주석자는 다양한 조직 사이의 실제 경계가 어디에 있는지 결정해야 합니다. 많은 경우에 이것은 부분적 볼륨 효과로 인해 사소하지 않았습니다. 따라서 이러한 결정과 결과적으로 훈련된 네트워크 모델은 고유한 관찰자 경험으로 편향될 수 있습니다. 또는 아래에 설명된 대로 명확한 위치의 신호만 사용하여 분류기를 훈련하기로 결정했습니다. 나중에 순방향 통과 추론 동안 논쟁의 여지가 있는 영역에 속하는 복셀을 객관적으로 구별하는 것은 알고리즘의 책임이었습니다.
마지막으로, 제안된 절차의 모든 계산 단위(CNN 및 분류기 모델, PCA 변환 행렬)는 현재 처리된 데이터 세트와 독립적인 환자 집단에 대해 획득되었습니다. 다음 하위 섹션에서는 알고리즘의 개별 모듈에 대한 구현 세부 정보를 제공합니다.
2.3. Cnnfor 시맨틱 분할
사용 가능한 U-Net 변형 중에서 [28]에 게시된 구현을 사용했습니다. 원본 논문[20]에서 설명한 아키텍처와 다르기 때문에 본 연구의 필요에 맞게 조정된 이 구조의 구체적인 특성을 먼저 요약한다.
2.3.1. 네트워크 아키텍처
U-Net 컨볼루션 신경망은 원래 전자 현미경 스택의 신경 구조 분할을 위해 개발되었으며 수많은 다른 생물 의학 응용 분야에서 효과적인 것으로 입증되었습니다. 말했듯이, 우리 모델에 대한 입력은 단일 3D DCE-MRI 볼륨의 단면 패치인 2D 그레이 레벨 이미지였습니다. 패치의 크기는 96 × 96 픽셀로 조정되었습니다(그림 2 참조).

U-Net의 특징은 수축 및 확장 경로의 두 가지 대칭 부분을 포함한다는 것입니다. 축소 경로의 목표는 훈련 가능한 가중치의 일련의 3 × 3 필터로 컨볼루션을 수행하여 이미지 픽셀의 강도 패턴을 인코딩하는 것입니다. 필터 출력은 네트워크의 주요 처리 구성요소인 ReLU(정류 선형 단위)라고 하는 뉴런을 활성화합니다. 이를 통해 이미지 기능과 출력 분할 맵 간의 비선형 관계를 모델링할 수 있습니다. 따라서 인코딩 단계는 디지털 이미지 처리에서 특징 추출로 알려진 프로세스와 비교할 수 있습니다. 그 다음에는 기능 맵을 다운샘플링하는 최대 풀링 작업이 수행됩니다.
다양한 스케일 레벨에서 이미지 디스크립터를 추출하기 위해 수축이 4번 반복됩니다. 실제로 각 레벨은 두 개의 컨볼루션 레이어로 구성된 블록으로 구성되며, 각 레이어는 지정된 배치 내에서 출력 임베딩의 평균과 표준 편차를 일정하게 유지하는 배치 정규화 레이어가 뒤따릅니다. 따라서 배치 정규화는 강도가 낮은 기능이 범위가 더 큰 기능과 동일한 중요성을 갖도록 합니다. 컨볼루션 및 정규화 레이어 쌍은 입력 노드의 20%를 무작위로 0으로 설정하는 드롭아웃 레이어에 의해 분리됩니다. 훈련 단계에서만 활성화되는 이 메커니즘은 네트워크가 과적합되는 것을 방지합니다[29].
병목 현상이라고 하는 마지막 다운 샘플링 블록의 출력은 확장 또는 디코딩 경로로 전달됩니다. 수축 부분과 동일한 수의 업샘플링 레벨로 구성되며 주요 작업은 원래 공간 해상도를 복구하는 것입니다. 본 연구에서는 전치 컨볼루션(transposed convolution)을 통해 업샘플링을 구현하였다. 각 디코딩 블록은 또한 두 쌍의 컨볼루션 및 배치 정규화 레이어로 구성되었습니다. 그러나 인코딩 블록과 달리 중간에 드롭아웃 메커니즘이 삽입되지 않았습니다. 또한, 다운샘플링 경로에서 추출된 고해상도 특징 맵은 후속 인코딩 레이어에 공급될 뿐만 아니라 업샘플링 경로의 각 수준에서 디코딩 레이어의 입력에도 연결되었습니다. 이러한 추가 연결은 디코딩 블록이 복원하는 데 도움이 되었습니다.신장세그먼트 현지화를 보다 정확하게 수행합니다.
그림 2에서 볼 수 있듯이 인코딩 블록은 수축 경로에서 더 깊이 내려가는 점점 더 많은 수의 컨볼루션 필터로 구성됩니다. 처음 두 개의 컨볼루션 레이어의 64개 필터에서 시작하여 병목 지점에서 기능 맵의 수는 1024개에 도달했으며 각 다운 샘플링 수준에서 두 배로 증가했습니다. 반대로, 확장 경로의 필터 수는 각 상향 단계에서 2의 인수로 나뉩니다. 결과적으로 최종 피쳐 맵은 다시 64의 깊이를 갖게 되었습니다.
마지막 업샘플링 블록의 출력은 1 × 1- 크기 필터가 있는 컨볼루션 레이어에 연결되었습니다. 64-요소 특성 벡터를 사용하여 필터 커널의 픽셀 단위 컨볼루션을 수행한 다음 그 결과를 출력 활성화 함수에 제출했습니다. 우리의 디자인에서는 최종 결정이 이진(픽셀은 신장 실질 또는 배경에 속함)이기 때문에 S자형 활성화가 사용되었습니다.
2.3.2. 훈련
네트워크 가중치는 He et al.의 방법에 의해 무작위 상태로 시작되었습니다. [30]. 교육 과정은 DCE-MRI 볼륨에서 자른 이미지 패치에 대해 수행되었으며, 각각은 단일, 왼쪽 또는 오른쪽을 포함합니다.신장교차 구역. 위에서 설명한 것처럼 96 × 96-픽셀 이미지 패치는 관류 단계, 즉 피질과 수질 사이의 최대 신호 대비 시간 프레임에 해당하는 DCE 시퀀스의 볼륨에서 추출되었습니다. 훈련 이미지의 수를 늘리기 위해 각 연구에 대해 실제로 3개의 이러한 시간 프레임을 선택했습니다. 하나는 피질 영역에서 최대 신호 향상이 있는 시간 프레임이고 하나는 이전 시간 프레임이고 다른 하나는 후속 시간 프레임입니다. 각 이미지 볼륨에서 단일신장평균 12개의 슬라이스에서 볼 수 있습니다. 약 1440개의 훈련 패치를 제공했습니다.
U-Net 네트워크는 일반적으로 작은 훈련 샘플을 처리할 수 있지만 데이터 증대를 통해 데이터 집합을 추가로 확장하기로 결정했습니다. 이것은 이미지 패치의 10가지 다른 수직 위치를 선택하고 수평 방향으로 무작위로 미러링하여 수행되었습니다. 패치 위치를 선택하는 동안 신장 실질의 상당 부분을 포함하는 이미지 중심의 충분히 큰 부분을 포함하도록 했습니다(그림 3 참조). 전체적으로 훈련에 사용할 수 있는 이미지의 수는 13,964개의 값에 도달했습니다. 훈련 이미지의 1/3은 검증 목적으로 분리되었습니다.

우리는 모든 환자에 대해 하나씩 10개의 서로 다른 CNN 모델을 훈련했습니다. 주어진 주제에 대한 전용 모델을 구축하는 동안 해당 이미지 패치(시험 세션에 관계없이)는 교육 및 검증 세트에서 제거되고 테스트용으로만 사용되었습니다. 네트워크의 가중치는 학습률이=0.01이고 운동량이=0.99인 확률적 경사하강법을 사용하여 업데이트되었습니다. 최적화를 위해 선택된 손실 함수는 다음과 같이 정의된 이진 교차 엔트로피 기준이었습니다.

여기서 N은 복셀의 수이고, Yi는 실제 복셀 레이블이며, p(Yi)는 i번째 벡터가 실제로 0 < p(Yi) < 1인 클래스 Yi에 속한다는 네트워크 예측입니다. 또한 , 품질을 모니터링하기 위해신장훈련 에포크에 대한 세분화, 우리는 Jaccard 계수를 계산했으며, 이하 IoU(intersection-over-union)로 지정됩니다.

여기서 K는 처리된 슬라이스의 픽셀 수를 지정하고 y는 예측된 픽셀 범주입니다. 여기에서 카테고리는 부울 값이고 픽셀이 다음에 속하는 경우 True로 레이블이 지정되었습니다.신장, 그렇지 않으면 False. 각 주제의 경우 최적화 알고리즘은 50 epoch 동안 실행되었습니다. 저장된 모델은 검증 데이터 세트에 대해 얻은 손실 함수에 대한 최소 점수가 있는 에포크에 해당합니다.
2.4. 분류신장복셀
2.4.1. 특징 추출
특정 신장 구획을 나타내는 복셀의 분화는 원시 신호 강도 시간 과정을 기반으로 할 수 있습니다. 그러나 우리는 주성분 분석(PCA)을 사용하여 신호 파형, 즉 74개의 시간적 특징의 벡터를 축소된 차원의 공간으로 변환할 것을 제안합니다. 이 변환의 목적은 결과 분류 모델의 복잡성을 줄이는 것뿐만 아니라 보다 일반적인 특성을 추출하는 것입니다.신장다양한 주제를 대표하는 조직. 더욱이, 동일한 임상 단위에서도 DCE 영상은 유사한 시간 범위를 다루지만 다른 시간 해상도를 갖는 순서로 수행될 수 있습니다. 따라서 PCA 변환 객체를 어댑터로 사용하여 균일한 특징 패턴을 수용하는 의사 결정 시스템은 가변 길이 입력 데이터 벡터에 적용될 수 있습니다.
추출된 PCA 구성 요소가 원래 데이터 세트 분산의 최소 90%를 설명해야 한다고 가정했습니다. 모든 주제에 대해 이 요구 사항을 충족하려면 최소 20개의 특성 집합을 구성해야 했습니다. 우리가 관찰한 바와 같이, 더 많은 수의 구성요소가 더 높은 분류 정확도로 이어지지 않았습니다.
2.4.2. 특징 벡터 분류
피질, 수질 또는 골반에 대한 신장 복셀의 할당은 감독 방식으로 훈련된 분류자가 수행합니다. 우리의 접근 방식에서 과거 데이터는 나중에 새로운 연구에 적용되는 적절한 의사 결정 규칙을 구축하기 위한 패턴 역할을 합니다. 우리는 모든 주제에 걸쳐 최상의 체계를 찾기 위해 세 가지 분류 알고리즘을 테스트했습니다. 검사된 방법에는 로지스틱 회귀, 지원 벡터 머신 및 XGBoost 결정 트리가 포함됩니다. 다음에서는 사용된 알고리즘의 특성을 상기하고 훈련 데이터가 어떻게 준비되었는지 설명합니다.
데이터 세트를 훈련하고 테스트합니다.훈련 벡터는 각 실질 위치에 수동으로 주석이 달린 관심 영역에서 획득했습니다. 주석은 구성원이 모호하지 않은 복셀에서만 작성되었으므로(그림 4a,b 참조), 다양한 구획으로 부분적으로 채워진 복셀의 경우 훈련된 분류자가 지배적인 조직 범주를 결정할 수 있습니다. 20개의 사용 가능한 시험에서 수집된 학습 벡터 수가 60,{3}} 값을 초과했습니다. 이 데이터 세트는 10개의 폴드로 분할되었으며 각 폴드에는 테스트 목적으로 남겨둔 한 주제를 제외한 모든 데이터 벡터가 포함되어 있습니다. 주어진 접힘에서 클래스 분포는 대략 다음과 같습니다: 피질-58%, 수질-31%, 골반-11% . 분류자가 동일한 정확도로 범주를 구별하는 방법을 배울 수 있도록 각 훈련 폴드에서 피질과 수질을 나타내는 하위 집합이 골반 범주의 크기와 일치하도록 다시 샘플링되었습니다. 평균적으로 리샘플링 후 학습 세트는 접기당 16개 이상의000 벡터를 포함했습니다. 주어진 훈련 폴드에 두 시험 세션의 데이터가 모두 포함되었습니다. 반면, 테스트 폴드에는 환자 및 검사 세션에 따라 600~4800개의 벡터가 포함되어 있습니다. 분류기는 테스트 세트에서 계산된 균형 정확도 점수를 사용하여 평가되었습니다.
로지스틱 회귀.로지스틱 회귀 분류기는 특징 벡터가 두 범주 중 하나에 속할 확률을 모델링합니다. 알고리즘은 훈련 데이터에 선형 함수를 맞추고 주어진 데이터 포인트에 대한 회귀 방정식의 결과는 로지스틱 변환에 제출됩니다.

여기서 p(yi|xi)는 Yi e {{0}}, 1}인 데이터 포인트 xi가 주어진 클래스 yi의 확률을 나타내는 반면, 가중치 벡터 w와 절편 w0는 피팅된 회귀를 결정합니다. 선.
이와 같이 수학식 3은 이진 분류 문제에 적용된다. 따라서 3개의 신장 영역의 경우 3개의 일대일 분류기를 구축하거나 다항 회귀 모델이 적합해야 합니다[31]. 우리의 실험에서는 후자의 변형을 사용합니다. 선형 모델의 매개변수 w는 L2 정규화 항을 사용하여 로그 손실 비용 함수를 최소화하여 찾습니다.

여기서 우리 연구 K=3 및 pi,c는 벡터가 클래스 c에 속할 예측 확률입니다. 위의 최적화 문제는 Scikit-Learn 패키지[33]에 구현된 SAG(Stochastic Average Gradient) 하강 알고리즘[32]으로 해결되었습니다. 대규모 데이터 세트에 대한 권장 사항과 L2 정규화 지원으로 인해 SAG를 선택했습니다.
벡터 머신을 지원합니다. 지원 벡터 머신(SVM)은 다른 범주를 구별하는 최대 마진 초평면을 구성하는 알고리즘 클래스를 구성합니다[34]. 벡터 x의 범주 구성원에 대한 결정은 초평면 방정식의 부호에 의해 결정됩니다.

여기서 I는 훈련 예제의 인덱스를 나타내고, xi는 해당 특징 벡터이고 Yi는 실제 클래스 레이블입니다. 이 모델을 훈련 데이터에 맞추는 동안 제약이 있는 이차 최적화 문제가 해결됩니다. 결과적으로 0이 아닌 Langrage 승수 ai가 발견되며, 이는 각각의 지원 벡터 xi 및 이동 매개변수 b와 함께 검색된 경계의 위치와 방향을 결정합니다.
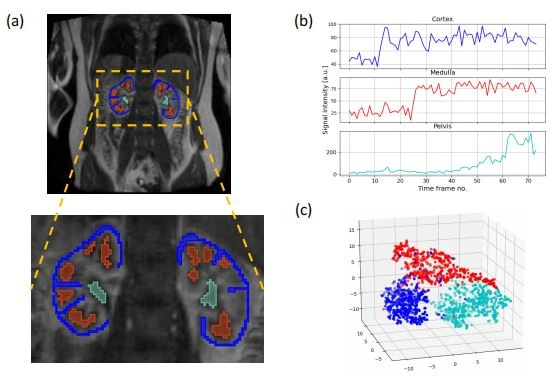
(5)의 내적은 커널 함수로 대체되어 비선형 문제에 SVM을 적용할 수 있습니다. 커널 트릭은 특징 벡터를 더 높은 차원의 공간으로 암시적으로 변환하여 분리 초평면을 결정할 수 있게 됩니다. 그림 4c는 참가자 중 한 사람에 대한 훈련 벡터 하위 집합의 분포를 보여줍니다. 이 시각화는 t-분산 확률적 이웃 임베딩(TSNE) 방법을 사용하여 20개의 PCA 특징 집합체의 공간에서 데이터를 3차원 공간으로 변환하여 얻은 것입니다[35]. 피질, 수질 및 골반 클래스의 선형 분리가 그럴듯하지만 분리 경계는 일부 비선형 함수에 의해 더 잘 모델링될 수 있음을 알 수 있습니다. 우리의 실험에서 방사형 기저 함수 커널에 의해 최상의 결과가 보장되었습니다.

어디 |.|é{0}}표준을 나타냅니다. 실제 데이터 세트에서 클래스의 완벽한 분리는 드물기 때문에 최적화 기준은 일반적으로 문자 C로 지정된 추가 메소드 매개변수를 통해 특정 수의 데이터 포인트가 결정 경계를 위반하도록 허용합니다. 및 C 매개변수는 반대로 SVM 모델의 복잡성에 기여합니다. 따라서 우리는 5중 교차 검증 실험에서 철저한 그리드 검색 알고리즘을 사용하여 값을 조정했습니다.=0.05 및
C = 1.
XGBoost 결정 트리.CART(분류 및 회귀 트리 앙상블)의 훈련을 용이하게 하기 위해 Chen과 Guestrin[36]에 의해 극한 그래디언트 부스팅(XGBoost) 개념이 도입되었습니다. 고전적인 랜덤 포레스트와 달리 학습 알고리즘은 다양한 목적 손실 함수의 정규화 메커니즘과 사용을 공식화합니다. 이러한 장점 덕분에 최근에 대규모 고차원 데이터 세트와 관련된 수많은 기계 학습 문제에서 효과적인 것으로 입증되었습니다.
XGBoost 앙상블의 구성은 소위 추가 훈련 전략을 기반으로 합니다. 각 단계 t에서 전체 손실 함수를 최소화하는 새 트리가 모델에 추가됩니다.

여기서 t ü 1)은 지금까지 구성된 앙상블에 의해 예측된 클래스 레이블이고, l은 예측된 레이블과 실제 레이블 Yi 간의 오차를 측정하는 반면, ft는 데이터 벡터와 함께 각각에 점수 wq를 할당하는 T 잎의 트리 구조에 해당합니다. (xi), q는 주어진 트리 리프에서 데이터 포인트 xi를 할당하는 함수입니다. T와 가중치 wj는 모두 정규화 항을 정의합니다.

여기서 및 λ 매개변수는 트리 크기의 영향을 제어하고 패널티 값에 점수를 남깁니다. 우리 연구에 사용된 구성에서 및 λ는 각각 {{0}}.1 및 0.9로 설정되었습니다. 또한 앙상블의 트리 수는 10개, 트리의 최대 허용 깊이는 4개였습니다. 결국 소프트맥스 함수를 객관적 기준 l로 사용했습니다.
2.5. 약동학 모델링
IoU 계수를 사용하여 분할 결과를 직접 평가하는 것 외에도 이미지 파생 GFR 값을 실제 iohexol 기반 측정과 비교했습니다. GFR 결정을 위해 우리는 다음을 사용했습니다.신장-특정 2구획 여과 모델(2CFM) [5]. 이 PK 모델은 신장 조직을 혈관내(IV) 및 세포외 혈관외(EEV) 공간으로 분해하고 모델링 기간 내에서 세뇨관 유출이 없다고 가정했습니다. 모델을 사용하여 피질 또는 전체 신장 실질에서 신장 관류를 추정할 수 있었지만 GFR을 계산하는 동안 이전 영역만 고려해야 했습니다.
모델을 측정된 신호 S(t)에 맞추려면 고려되는 신장 영역과 별도로 각각의 평균 이미지 강도 시간 경과를 농도 파형 Ctissue(t)로 변환해야 합니다. 그래디언트 에코 시퀀스에 맞게 조정된 [37]에 설명된 변환을 사용하여 이를 수행했습니다. 한편, 2CFM 모델에 의해 기술된 C tissue(t)는 방정식에 의해 지배된다.

여기서 C는 동맥 입력 기능, VP -혈장 부피 분율 및 혈장 내 C-CA 농도를 나타냅니다. (9)의 첫 번째 항은 EEV 공간의 CA 농도를 나타내는 반면, 두 번째 항은 동맥 입력 함수와 혈관 임펄스 응답 함수(VIRF)를 결합하여 얻은 IV 공간의 농도를 나타내며, 다음과 같이 정의됩니다.


이와 같이 VIRF는 모세관 베드를 통한 CA 흐름에 대한 AIF의 지연 및 분산을 모델링합니다. 변수 Tg(분산 시간 상수) 및 X(지연 간격)는 체적 분율 VP 및 전달 상수 Ktrans와 함께 2CFM 모델 매개변수의 완전한 세트를 형성합니다. 그들의 추정은 일반적으로 NLLS(Non-Linear Least Squares) 곡선 맞춤 절차에서 수행됩니다. 본 연구에서 사용된 Trust Region-Reflective 방법[38]은 NLLS 문제를 수치적으로 풀기 위해 사용되는 가능한 최적화기 중 하나이다. 하향식 방법과 달리 매개변수 값에 대한 제약 조건을 설정할 수 있으므로 최종 추정값이 생리학적 범위에 속하는지 확인할 수 있습니다. 본 연구에서 가정한 제약조건은 Table 1과 같다.

[39]에서 다운로드할 수 있는 Python으로 작성된 사용자 지정 소프트웨어에서 2CFM 모델 최적화 알고리즘을 구현했습니다. 알고리즘은 위에서 설명한 세분화 파이프라인에 의해 자동으로 획득되거나 수동으로 주석이 달린 피질 영역을 사용하여 각 환자에 대해 시작되었습니다. 어쨌든 AIF는 [40]에서 앞서 발표한 방법을 사용하여 자동으로 결정되었습니다.
2.6. 통계 분석
DCE-MR 이미지 분할 프로세스를 자동화하는 목표 중 하나는 안정적이고 반복 가능한 관류 추정치를 보장하는 것입니다. 따라서 우리는 관련(반복) 샘플에 대해 스튜던트 t-검정을 수행하여 두 가지 검사 이벤트에서 추정된 동일한 GFR 평균의 귀무 가설을 확인했습니다. 또한 [41]로 정의된 반복성 계수를 계산했습니다.

여기서 σdiff는 동일한 주제에 대해 만들어진 GFR 간의 차이의 표준 편차이고 ╱pool은 모든 측정의 평균을 나타냅니다. 단일 측정 표준 편차(σsm)라고도 하는 양 '2σdiff는 잠재적으로 많은 연속 측정 쌍에서 차이의 표준 편차 추정값입니다[42]. 반복성 평가 외에도 Bland-Altman 플롯을 사용하여 이미지 기반 GFR 추정의 재현성을 평가했습니다. 결국, 자동으로 발견된 신장 세그먼트에 대해 달성된 분석 결과를 수동 주석과 비교했습니다.

Cistanche는 완화할 수 있습니다신장효과적으로
3. 결과
그림 5는 실측 주석 마스크와 함께 참여하는 두 주제에 대한 의미론적 분할 네트워크의 출력 예를 보여줍니다. 해당 훈련 프로세스는 훈련 및 검증 세트 모두에 대한 손실 및 평가 메트릭의 발전을 플롯한 그림 6에 시각화되어 있습니다. 처음 몇 에포크 후에 훈련 및 검증 세트에 대한 IoU 곡선이 서로 가깝게 놓여 있고 네트워크가 과적합 상태에 들어가지 않았음을 관찰할 수 있습니다. 동시에 손실 함수의 단조로운 감소가 발생하여 네트워크가 일반화 능력을 얻었음을 증명했습니다. 수동 주석과 자동으로 찾은 주석 간의 IoU 유사성 계수신장주요 분절과 분리된 신장 외 섬을 제거한 후 얻은 영역은 표 2에 수집되어 있습니다. 모든 대상 및 연구에 대한 평균 IoU는=0.94이며 측면에서 무관심한 것으로 나타났습니다.

다음 단계에서 실질 복셀은 별도의 신장 구획으로 분류되었습니다. 세 가지 테스트된 분류기의 비교가 표 3에 나와 있습니다. 균형 정확도, 재현율 및 정밀도의 세 가지 메트릭과 관련하여 각 방법을 평가합니다. 후자의 두 가지는 각 신장 범주에 대해 별도로 결정되었습니다. 균형 잡힌 정확도 메트릭은 특정 클래스에 대해 얻은 참 양성 비율의 평균으로 얻었습니다. 제시된 모든 점수는 20명의 시험 대상자에 대한 평균 값이었습니다. 테스트를 거친 3개의 분류기는 진양성률(약 95%) 측면에서 유사한 성능을 달성했습니다. 그러나 전반적으로 가장 균형 잡힌 정확도(96%)를 나타내고 위양성 탐지를 피하기 위해 다른 방법보다 더 큰 능력을 얻은 것은 SVM이었습니다. 특히 눈에 띄었다
골반 영역의 경우 로지스틱 회귀 및 XGBoost 분류기가 제공하는 89%에 대한 정밀도=92%입니다.
높은 분류 정확도는 똑같이 우수한 분할 결과로 변환되었으며(표 2), 이 결과는 Jaccard 계수를 사용하여 다시 평가되었습니다. 그러나 이번에는 각 지역별로 별도로 결정된 IoU의 합으로 계산한 다음 해당 지원, 즉 주어진 클래스를 나타내는 ground-truth voxel의 수로 가중치를 부여했습니다. 다른 작품과의 비교를 가능하게 하기 위해 구한 Jaccard rate to Dice coefficients(F1-score)를 공식으로 다시 계산했습니다.

알고리즘을 사용하여 왼쪽의 피질 클래스에 대한 평균 자카드 계수를 얻었습니다.신장93.2%와 동일합니다. 다른 지역의 경우 IoU가 약 91%에 달했으며, 왼쪽 골반 클래스를 제외하고는신장 90.1퍼센트로 떨어졌습니다. 미세 분할의 품질은 다음의 예를 분석하여 시각적으로 확인할 수 있습니다.신장 더 넓은 맥락에서 평가를 가능하게 하기 위해 우리는 또한 문헌에서 제안된 두 가지 대체 방법으로 분할을 수행했습니다. 첫 번째는 예를 들어 [12]에서 가정된 것처럼 Daubechies{1}} 웨이블릿과 함께 이산 웨이블릿 변환(DWT)을 사용하여 DCE 신호 특성을 추출하는 것입니다. 그런 다음 SVM 알고리즘을 사용하여 DWT 계수 벡터를 분류했습니다. 두 번째 비교 방법에서 PCA 특징 벡터는 [14]에 설명된 대로 k-means 알고리즘(k=3 포함)을 사용하여 클러스터링되었습니다. 이 두 번째 접근 방식은 피질과 수질을 제대로 구분하지 못했습니다. 두 지역을 대표하는 대부분의 복셀은 공통 클러스터에 포함되었으며 대부분의 횡단면에서 골반만 실질의 자율적인 부분으로 인식되었습니다. 클러스터링으로 얻은 결과와 달리 DWT 기반 복셀 설명을 사용하여 감독 방식으로 생성된 영역이 더 정확합니다. 그러나 잘못된 인식의 수는 PCA 특징 벡터의 경우보다 분명히 더 많습니다. 이 경우 SVM 분류기에 대해 얻은 균형 정확도 점수는 78%에 불과했습니다. Xgboost, 선형 회귀 및 연구 SVM/PCA 알고리즘에서 가장 좋은 이러한 대체 분할 체계의 양적 비교에 대해서는 표 3의 마지막 두 행을 참조하십시오.

분할 단계의 결과는 신피질의 평균 신호를 결정하는 데 사용되었습니다. 그런 다음 이 신호를 2CFM 약동학 모델에 맞추었습니다. 그림 8은 단일신장사구체 여과율이러한 방식으로 얻은 (SK-GFR)은 수동 주석을 사용하여 파생된 관련 점수에 해당합니다. 자동 및 수동 분할 후 얻은 모든 대상 및 연구에 대한 평균 SK-GFR 값은 유사하고(56 대 55 mL/min/1.73 m2) 관찰된 차이는 통계적으로 유의하지 않습니다(T-통계=0.75, p-값=0.46). 또한 두 측정 유형 간의 선형 맞춤은 MR 검사 세션 1과 2에서 각각 r{13}}.13 및 0.49와 잘 일치함을 증명합니다.

그림 9에 표시된 Bland-Altman 플롯을 통해 총 GFR과 실측 iohexol 기반 비율의 일치를 평가할 수 있습니다. Bland-Altman 방법을 적용하기 전에 Shapiro-Wilk 테스트를 사용하여 측정값의 정규 분포를 확인했습니다. 얻은 p-값은 관련 플롯 범례에 나와 있습니다. 절대값 측면에서 MR 검사 세션 1의 평균 차이는 수동 분할에서 더 작았습니다(ü0.8 대 ü7.4 mL/min/1.73 m2). 세션 2의 경우 ╱d의 값은 세분화 방법 간에 일치했지만 참조 방법과의 일치도는 약했습니다. 그러나 제안된 알고리즘은 약간 더 나은 성능을 보이는 것으로 나타났습니다(ü 12.9 대 ü 14.1 mL/min/1.73 m2). 얻은 결과를 기반으로, 어떤 세분화 접근 방식이 더 좁은 합의 한계를 보장하는지 결정할 수 없었습니다. 세션 1의 경우 비교에서 수동 분할이 선호되었습니다(π=31.3 대 35.5 mL/min/1.73 m2). 그러나 세션 2 및 자동 라벨링(π=25.1 mL/min/1.73 m2)에 대해 모든 실험에서 일치 및 신뢰 구간의 가장 좁은 한계를 얻었습니다. 두 분할 접근 방식 모두 최악의 경우(수동 분할, 왼쪽) 변동 계수가 30.2%인 반복 가능한 결과(표 4 참조)로 이어졌습니다.신장). 분명히 자동 분할은 수동 대응의 경우보다 2배 낮은 변동 계수로 더 나은 안정성을 보장했습니다. 관련 샘플에 대한 스튜던트 t-검정에서 얻은 p-값은 모두 신뢰 수준 a=0.05보다 높았으며, 이는 SK-GFR 측정의 관측된 평균 간에 유의한 차이가 없다는 귀무 가설에 대한 증거가 불충분함을 보여줍니다. 그러나 왼쪽 신장 및 수동 분할에 대해 계산된 p-값은 상대적으로 작았습니다. 이 경우 측정의 반복성을 확인하거나 거부하려면 더 큰 샘플을 포함할 수 있는 추가 조사가 필요합니다.

4. 토론
이 연구의 주요 목표는 효과적인 방법을 설계하는 것이 었습니다.신장DCE-MR 이미지의 분할. 우리는 이전에 출판된 작품에서 부분적으로 제안된 개념을 균일한 계산 프레임워크로 결합했습니다. 그것은 신장 실질의 거친 의미론적 분할, MR 신호 시간 과정의 PCA 변환을 포함하여 복셀 수치 표현을 생성한 다음 분류를 통해 신장 조직을 피질, 수질 및 골반으로 미세 분할할 수 있습니다. 제안된 접근 방식은 정확한 결과로 이어지며 자카드 계수 측면에서 94%의 비율로 신장 인식을 가능하게 합니다. 특정 신장 구획의 분할은 조직 유형에 따라 90%에서 93%(주사위 계수의 96-95%) 사이의 IoU로 달성할 수 있습니다.

다른 공개된 결과를 참조할 때 얻은 비율은 일치하거나 약간 낮습니다. [14]에서 건강한 사람에 대한 주사위 점수는신장분할은 99%(피질), 98%(수질) 및 96%(골반) 수준에서 보고되었습니다. 그러나 이미지 노이즈가 정확도를 82–85%로 크게 저하시킬 수 있는 시뮬레이션 데이터도 표시되었습니다. 그 안에서 그리고 우리 연구에서 사용된 이미징 프로토콜은 공간적 및 시간적 해상도와 관련하여 다르기 때문에 1-2% 범위에서 관찰된 불일치는 우리 연구의 다양한 소음 수준에 기인할 수 있습니다. [15]의 한 소아 환자 그룹에서 유사한 스캔 조건이 사용되었습니다. 여기에서 관찰된 평균 F{8}}점수는 전체에 대해 93%였습니다.신장, 그리고 신피질의 경우 86퍼센트. [12]에서 클러스터링 기반 세분화는 정확도 점수를 사용하여 평가되었습니다. 평균적으로 얻은 결과는 피질 88%, 수질 91%, 골반 98%였습니다. 이러한 값은 주어진 세그먼트의 크기를 고려한 균형 정확도 점수로 집합적으로 참조할 수 있습니다. 따라서 우리의 SVM 모델은 분류 정확도를 제공하는 클러스터링 기반 접근 방식을 능가하는 것으로 보이며, 가장 큰 피질 영역에서도 96% 수준의 재현율을 제공합니다.
결국 CNN 네트워크는 전체 인식에 전념했습니다.신장[26]에 설명된 U-Net 설계보다 낮은 성능을 보여 일반 테스트 대상에 대해 F1-점수=91.4%를 달성했습니다.
분할 결과에서 관찰된 차이는 알고리즘 학습-회상 구성에 비추어 볼 수도 있습니다. 일부 대안적 접근법[11,14]과 달리 우리의 전략은 환자 독립적입니다. 의미론적 세분화 및 분류 모델이 구축되면 훈련 세트에서 만나지 못한 새로운 연구에 적용됩니다. 따라서 환자별 특징은 인식 메커니즘을 안내할 수 없고 훈련된 모델에 적합하지 않아 전체 정확도가 감소할 수 있습니다. 또한 위에서 논의한 바와 같이 피질, 수질 및 골반 사이의 경계에서 부분적 볼륨 효과가 지속되기 때문에 보고된 메트릭을 분석하는 동안 고려해야 하는 참조 수동 분할과 관련하여 약간의 불확실성이 남아 있습니다. SVM 분류기는 신중하게 선택된 조직 고유의 실제 신호에 대해 훈련되었지만 모든 신장 복셀을 포함해야 하는 검증 데이터는 여전히 관찰자 주석의 주관주의로 인해 어려움을 겪을 수 있습니다.
정확한 세분화 결과를 생성하는 관찰된 힘 외에도 우리의 전략은 한 가지 유리한 특성을 가지고 있습니다. 감독된 분류기를 사용하여 적절한 이미지 복셀을 할당하기 때문에신장지역에서는 별도의 라벨링 단계가 필요하지 않습니다. 클러스터링의 경우 전체 절차의 자동화를 보장하려면 각 클러스터의 실제 범주를 해석하기 위해 약간의 휴리스틱을 제공해야 합니다.
그림 10에서 볼 수 있듯이 자동 주석과 수동 주석 간의 불일치에는 주로 두 가지 원인이 있습니다. 첫째, 피질과 수질 피라미드의 경계가 모호하고 해당 복셀이 부분적으로 두 종류로 채워져 있습니다.
신장 조직의. 자동 방법은 피질 클래스에 이러한 복셀을 포함하는 경향이 있지만 전문가에 의해 수질로 지정되는 경우가 많습니다. 반면에 수동 분할조차도 이러한 점에서 일관성이 없어 부분 볼륨 효과가 지배적인 복셀의 클래스를 임의로 결정하기가 어렵습니다. 둘째, 예를 들어 외부 피질 가장자리에서 잘못된 탐지가 관찰될 수 있습니다. 이러한 효과는 시간 영역에서 이미지가 잘못 등록되었기 때문일 수 있습니다. 적용된 b-spline 등록 방법은 본 연구의 필요에 최적화되지 않았으며 향후 연구 주제로 남아 있습니다.
또한 수행된 실험은 제안된 분할 알고리즘이 이미지 기반 SK-GFR 추정의 반복성을 향상시키는 것으로 나타났습니다. 계산된 변동계수는 좌우 14.5%, 17.5%로 나타났다.신장, 각각. 수동 주석의 경우 CoV=30.2% 및 29.4%를 얻었습니다. 이러한 결과는 식단 및 시간과 같은 독립적인 요인에 의해 야기되는 자연적인 GFR 변화와 관련하여 평가되어야 합니다. GFR과 잘 상관되는 혈청 크레아티닌 수준은 최대 10%의 변동 정도를 달성할 수 있을 것으로 예상됩니다[43]. 따라서 CoV는 약. 15%는 자동화된 시스템을 활용하는 절차의 우수한 반복성을 나타냅니다.신장분할. 또한 획득한 반복성 측정항목은 [44] CoV=32 퍼센트 및 27퍼센트와 같이 다른 곳에서 제시된 값 범위에 속하지만 [13]에서는 CoV=17.5퍼센트 및 15.4퍼센트 왼쪽과 오른쪽신장, 각각. 그러나 후자의 연구에서 CoV는 σsm의 비율과 모든 측정값의 평균으로만 계산되었으며 '2의 추가 요소가 없습니다. 이 보정 계수를 반영하면 보고된 CoV는 24.7%와 21.8%가 되며 이는 우리의 결과에 상당히 가깝습니다.

우리 연구의 세 가지 한계를 제기할 수 있다. 첫째, 이미지 패치로의 가정된 분할은 의미론적 분할 네트워크가 학습하도록 기울일 수 있습니다.신장패치 가장자리 중 하나 근처에만 위치합니다. 따라서 우리 모델의 추가 개발에서는 획득 시야가 다르게 구성되는 경우 알고리즘이 어떻게 수행되는지 연구할 것입니다. 둘째, 건강한 피험자만을 대상으로 분할 알고리즘을 설계하였다. 이는 신장 실질의 미세 분할의 경우에 특히 중요한 결과를 초래할 수 있습니다. 병든 신장에 대한 분류 모델을 조정하려면 신장 조직 병변의 다양한 시간적 특성을 반영하기 위해 클래스 수를 세 가지 범주(피질, 수질 및 골반) 이상으로 확장해야 할 수 있습니다. 셋째, GFR을 계산하기 위해 분할된 피질에서 추정된 평균 DCE 신호에 2CFM 모델을 맞추었다. 부분 부피 효과로 인해 수동 및 자동 분할은 일부 복셀을 수질로 분류할 수 있지만 신장 사구체를 포함합니다. 이러한 복셀을 무시하는 것은 이미지 파생 GFR 측정과 iohexol 기반 GFR 측정 간에 관찰된 불일치에 대한 이유 중 하나일 수 있습니다. 이 문제를 극복하기 위해 일부 저자[5]는 신장 여과에 기여하는 모든 복셀이 PK 모델 피팅 프로세스에 포함되도록 전체 신장 ROI를 사용할 것을 제안합니다. 그러나 우리는 이 접근 방식이 우리 연구에서 사용 가능한 데이터 세트에 대한 GFR의 현저한 과대 평가로 이어진다는 것을 발견했습니다. 따라서 향후 딥러닝 기반의 초해상도 기법을 적용하여 피질 복셀에 대한 보다 정확한 주석을 얻을 수 있도록 노력할 계획입니다.
또한 의미론적 분할에 대한 완전한 3D 접근 방식을 활용해야 합니다. 전체 MR 볼륨을 처리할 수 있는 신경망이 보다 정확한신장추가 깊이 정보 덕분에 주석. 그러나 본 연구의 문제는 훈련할 수 있는 연구의 수가 상대적으로 적기 때문에 2차원으로 축소되어야 했다. 체적 이미지를 2D 단면으로 분해하면 훈련 데이터 세트를 크게 늘릴 수 있습니다.
결국, 이전에 설명된 바와 같이 제안된 접근 방식은 하나의 주제에서 벗어나는 방식으로 검증되었습니다. 효과적인 10개의 독립적인 신경망과 분류기 모델이 생성되었습니다. 정당한 질문은 이 모델이 이 연구에서 사용할 수 있는 샘플 외부의 새로운 주제에 어떻게 적용될 수 있는지입니다. 한 가지 옵션은 앙상블을 만들고 투표 메커니즘을 도입하는 것입니다. 또는 전체 10-주제 샘플을 기반으로 새로운 세분화 체계를 학습할 수 있습니다(거친 단계와 세분화된 단계 모두 포함). 새로운 데이터 세트에 대한 성능은 위에 제시된 결과와 유사해야 합니다.

cistanche는 완화할 수 있습니다신장고통, 자세한 내용을 보려면 여기를 클릭하십시오
5. 결론
결론적으로, 이 논문에서 우리는 정량적 평가를 지원하기 위한 계산 프레임워크를 시연했습니다신장신장 구획 분할의 자동화된 방법을 제공함으로써 관류. 얻어진 정확도 결과는 설계된 방법의 안정적인 작동을 증명합니다. 또한, 우리의 실험에서 웨이블릿 변환 및 클러스터링 알고리즘을 기반으로 피질, 수질 및 골반 세그먼트를 구별하는 대체 접근 방식은 덜 효과적으로 수행됩니다. 자동으로 찾은 세그먼트를 기반으로 하는 SK-GFR 측정의 반복성은 수동 처리의 결과와 비교할 때 향상되고 다른 게시된 결과와도 잘 일치합니다. 설계된 분할 방법을 통해 이미지에서 파생된 관류 매개변수의 객관성을 높이고 잠재적으로 신장 손상을 더 빨리 진단할 수 있습니다. 이러한 발견은 DCE-MR 영상을 일상적인 방법으로 임상에 적용하는 데 더 가깝습니다.신장진단. 마지막으로 연구에서 응용 분야로의 이러한 전환을 촉진하기 위해 [39]에서 약동학 모델링을 위한 소프트웨어 프레임워크를 사용할 수 있습니다. 저장소에는 DCE 신호 기반 기능 추출 및 분류를 위한 스크립트도 포함되어 있습니다.
저자 기여:개념화, AK; 방법론, AK 및 EE; 소프트웨어, AK; 검증, AK; 공식 분석, AK; 조사, AK; 자원, EE 및 AL; 데이터 큐레이션, EE; 쓰기 - 원본 초안 준비, AK; 쓰기 - 검토 및 편집, AL 및 EE; 시각화, AK; 감독, AL; 프로젝트 관리, AK 모든 저자는 출판된 원고 버전을 읽고 동의했습니다.
자금:이 연구는 외부 자금 지원을 받지 않았습니다.
기관 검토 위원회 성명서:이 연구는 헬싱키 선언에 따라 수행되었으며 프로토콜은 서부 노르웨이 의료 연구 윤리를 위한 지역 위원회(REC West 2012/1869)의 승인을 받았습니다.
사전 동의 진술:모든 피험자는 연구에 참여하기 전에 포함에 대해 사전 동의를 받았습니다.
데이터 가용성 설명:이 연구에 사용된 DCE-MR 이미지는 참가자가 서명한 서면 동의가 획득한 데이터의 공개 배포에 대한 동의를 다루지 않았기 때문에 사용할 수 없습니다.
이해 상충:저자는 이해 상충을 선언하지 않습니다.
참고문헌
1. 자벨, JR; 라슨, G.; Koffel, J.; 리, 디.; 앤더슨, JK; 체중, CJ 추정을 위한 신장 질환 방정식에서 식이 수정의 사용 사구체 여과율비뇨기과 문헌에서. J. 엔듀롤. 2016, 30, 930–933.
2. Delaney, P.; 에버트, N.; Melsom, T.; Gaspari, F.; 마리아트, C.; Cavalier, E.; Björk, J.; 크리스텐슨, A.; Nyman, U.; 포리니, 이.; et al. 측정을 위한 Iohexol 플라즈마 클리어런스사구체 여과율임상 실습 및 연구: 검토. 파트 1: 측정 방법사구체 여과율아이오헥솔? 클린.신장J. 2016, 9, 682–699.
3. Annet, L.; Hermoye, L.; Peters, F.; 자마르, F.; Dehoux, JP; Van Beers, BE 사구체 여과율: 동적 조영제 강화 MRI 및 토끼의 피질 구획 모델을 사용한 평가신장. J. Magn. 공명. 이미징 2004, 20, 843–849.
4. Sourbron, SP; 마이클리, HJ; 라이저, MF; Schoenberg, SO MRI-인간의 관류 및 사구체 여과 측정신장분리형 구획 모델. 조사 라올. 2008, 43, 40–48.
5. 토프트, P.; Cutajar, M.; Mendichovszky, I.; Peters, A.; Gordon, I. 동적 조영증강 MRI용 2구획 모델을 사용한 신장 여과 및 혈관 매개변수의 정확한 측정신장현실적인 정상 값을 제공합니다. 유로 라올. 2012, 22, 1320–1330.
6. Chen, B.; Zhang, Y.; 송, X.; 왕, X.; Zhang, J.; Fang, J. 수정된 2구획 모델을 사용한 동적 조영증강 MRI를 사용한 신장 기능의 정량적 추정. 플로스원 2014, 9, e105087.
7. Cutajar, M.; Mendichovszky, I.; Tofts, P.; Gordon, I. DCE-MRI renography에서 AIF ROI 선택의 중요성: 신장 관류 및 여과의 재현성 및 가변성. 유로 J. Radol. 2010, 74, e154–e160.
8. 이 VS; Rusinek, H.; 보카체바, 엘.; 황, AJ; Oesingmann, N.; 첸, 큐.; 카우르, 엠.; 프린스, K.; 송, 티.; Kramer, EL; et al. MR 신조영술과 단순화된 다구획 모델로부터의 신장 기능 측정. 이다. J. Physiol.-신장 Physiol. 2007, 292, F1548–F1559.
9. Patlak, CS; Blasberg, 다중 시간 흡수 데이터에서 혈액 대 뇌 전달 상수의 RG 그래픽 평가. 일반화. J. 세렙. 혈류 대사. 1985, 5, 584–590.
10. Hackstein, N.; Heckrodt, J.; Rau, WS 단일 측정신장대조 강화 동적 기울기-에코 시퀀스와 Rutland-Patlak 플롯 기법을 사용한 사구체 여과율. J. Magn. 공명. 이미징 2003, 18, 714–725.
11. Zöllner, F.; 산스, R.; Rogelj, P.; Ledesma-Carbayo, M.; Rørvik, J.; A. 산토스; Lundervold, A. 3D DCE-MRI 평가신장비강체 이미지 등록 및 복셀 시간 코스 분할 사용. 계산 메드. 이미징 그래프. 2009, 33, 171–181.
12. Li, S.; Zöllner, F.; Merrem, A.; Peng, Y.; Roervik, J.; Lundervold, A.; Schad, L. 인간의 DCE-MRI에서 신장 구획의 Wavelet 기반 분할신장: 환자와 건강한 지원자의 초기 결과. 계산 메드. 이미징 그래프. 2012, 36, 108–118.
13. Eikefjord, E.; Andersen, E.; Hodneland, E.; Hanson, E.; Sourbron, S.; Svarstad, E.; Lundervold, A.; Rørvik, J. 건강한 참가자의 신장 기능에 대한 동적 대비 강화 MRI 측정. 액타 라올. 2017, 58, 748–757.
14. 양, X.; 레민, H.; 쳉, KT; 성경호; Liu, W. DCE-MRI 이미지의 신장 구획 분할. 메드. 이미지 항문. 2016, 32, 269–280.
15. 요룩, U.; 하그리브스, BA; Vasanawala, SS 3D-GrabCut 및 랜덤 포레스트를 사용한 MR 요로조영술을 위한 자동 신장 분할. 매그. 공명. 메드. 2018, 79, 1696–1707.
16. Lundervold, AS; Lundervold, A. MRI에 초점을 맞춘 의료 영상의 딥 러닝 개요. Z. Für Med. 물리. 2019, 29, 102–127.
17. 칸, Z.; Yahya, N.; Alsaih, K.; 알리, SSA; Meriaudeau, F. T2W MRI에서 전립선의 의미론적 분할을 위한 심층 신경망 평가. 센서 2020, 20, 3183.
18. Shelhamer, E.; 긴, J.; Darrell, T. 의미론적 분할을 위한 완전 컨볼루션 네트워크. IEEE 트랜스. 패턴 항문. 마하. 인텔. 2017, 39, 640–651.
19. Badrinarayanan, V.; 켄달, A.; Cipolla, R. SegNet: 이미지 분할을 위한 심층 컨볼루션 인코더-디코더 아키텍처. IEEE 트랜스. 패턴 항문. 마하. 인텔. 2017, 39, 2481–2495.
20. Ronneberger, O.; 피셔, P.; Brox, T. U-Net: 생의학 이미지 분할을 위한 컨볼루션 네트워크. In Proceedings of the 18th International Conference on Medical Image Computing and Computer-Assisted Intervention, 독일 뮌헨, 2015년 10월 5-9일; 234~241쪽.