구문 청킹은 생성적이고 자동인 여러 자리 숫자의 핵심 구문 표현을 보여줍니다. 2부
Oct 26, 2023
데이터 코딩
각 숫자 단어는 어휘 클래스(이 실험에서는 1, 10 또는 100만 사용함)와 1~9 값에 의해 고유하게 정의됩니다. 예를 들어, ffty라는 단어는 숫자 5와 클래스 Tens의 조합입니다. 마찬가지로 "fourhundred"(아마도 히브리어의 단일 어휘-음운학적 값)는 Hundreds 클래스의 숫자 4입니다. 이에 따라 숫자 단어의 인지적 표현은 두 가지 형태소, 숫자, 클래스로 이루어져 있으므로(McCloskey et al., 1986), 우리의 코딩은 이 두 형태소를 기반으로 했습니다. 십진수 단어 "thousand"는 예외였습니다. 우리는 이를 숫자 형태소가 없는 단일 형태소, 어휘 클래스 "thousand"로 간주했습니다.
인코딩과 메모리 사이에는 분리할 수 없는 관계가 있습니다. 인코딩은 정보를 인간의 두뇌가 처리할 수 있는 형식으로 변환하는 것을 의미하며, 메모리는 정보를 저장하고 검색하는 과정을 의미합니다. 인코딩 과정은 정보를 유지하고 필요할 때 불러올 수 있는지 여부를 결정하므로 기억 생산에 중요한 영향을 미칩니다.
일반적으로 인간의 기억은 단기기억과 장기기억으로 구분됩니다. 단기 기억은 일반적으로 더 짧은 기간 동안만 정보를 저장할 수 있는 반면, 장기 기억은 더 오랜 기간 동안 정보를 저장할 수 있습니다. 사람의 기억 능력에 있어서 부호화는 기억 저장 이전의 첫 번째이자 가장 중요한 단계입니다. 인코딩에 문제가 있으면 정보를 저장하거나 검색하기가 어렵습니다.
인코딩 품질은 메모리에 큰 영향을 미칩니다. 시각, 청각, 후각 등 다양한 감각을 인코딩에 사용할 수 있다면 정보 인코딩의 효율성을 높이고 기억력을 강화할 수 있습니다. 동시에, 정보를 장기 기억에 이미 존재하는 정보와 연결하여 더 쉽게 기억할 수 있도록 "의미 이해" 방법을 사용해야 합니다.
또한, 부호화와 기억 사이에는 검토와 검색 사이에 관계가 있습니다. 검토란 정보가 저장된 후 상대적으로 오랜 기간 동안 기억 시스템에 남아 있도록 다시 읽고, 듣고, 보는 것을 의미합니다. 추출이란 정보를 꺼내어 필요할 때 사용하는 것을 말합니다. 인코딩 검토 및 검색을 효과적으로 수행할 때 주의를 기울이면 기억력이 크게 향상됩니다.
인생에서 공부, 직장, 사회생활의 정보를 포함하여 대부분의 정보는 기억되어야 합니다. 그러므로 우리 뇌에 정보를 효과적으로 저장하려면 인코딩 과정을 진지하게 받아들여야 합니다. 좋은 코딩 기술을 습득해야만 정보를 더 잘 저장, 검토 및 검색하고 기억력을 향상시킬 수 있습니다. 기억력 향상이 필요하다고 볼 수 있는데, Cistanche Deserticola는 아세틸콜린 수치와 성장인자 수치를 높이는 등 신경전달물질의 균형도 조절할 수 있기 때문에 기억력을 크게 향상시킬 수 있습니다. 이 물질은 기억과 학습에 매우 중요합니다. 또한 고기는 혈류를 개선하고 산소 전달을 촉진하여 뇌에 충분한 영양분과 에너지를 공급하여 뇌의 활력과 지구력을 향상시킵니다..

우리는 숫자 형태소, 클래스 형태소 또는 둘 다의 정확성을 반영하여 각 시험에 대해 3가지 성능 측정을 정의했습니다. 숫자 정확도는 순서에 관계없이 과도한 숫자를 무시하고 응답으로 나타나는 자극 숫자의 백분율로 정의됩니다. 이번 측정에서는 '천'이라는 단어가 제외되었습니다. 클래스 정확도는 순서에 관계없이 과도한 클래스를 무시하고 응답으로 나타나는 자극 어휘 클래스의 백분율로 정의됩니다. 자극에 어휘 클래스가 두 번 포함되었지만(예: "9만 팔십"의 10 클래스) 응답에는 한 번만 포함된 경우 정확도 2점 만점에 1점만 기록됩니다. 마지막으로 형태소 정확도는 두 클래스를 병합하여 정의되었습니다. 즉, 순서에 관계없이 참가자의 응답에 나타난 숫자 및 클래스 형태소의 비율입니다. 아래 텍스트에서는 형태소, 숫자 및 클래스 오류율, 즉 정확도 100%에 대한 보완을 보고합니다.
네 번째로 가능한 측정값은 단어 정확도, 즉 응답에 나타난 자극 단어의 비율입니다. 형태소 정확도와 유사하게 이 측정값은 클래스와 숫자를 모두 고려하지만 특정 클래스와 특정 숫자의 올바른 쌍도 필요합니다. 예를 들어, 23분 32분을 반복하면 0% 단어 정확도 및 100% 형태소 정확도로 코딩됩니다. 단어 정확도 결과는 여기에 보고되지 않지만 기본적으로 형태소 정확도 결과와 동일합니다.
통계 분석
두 조건을 비교하기 위해 각 시행의 숫자, 클래스 또는 형태소 오류율을 선형 혼합 모델(LMM)의 종속 변수로 입력했습니다. 참가자와 자극은 무작위 요인이었고 조건은 참가자 내, 자극 내 요인이었습니다. 모델이 수렴하지 않는 소수의 경우 자극 무작위 요인이 이동되었습니다. 서로 다른 참가자가 서로 다른 길이의 자극을 반복한다는 사실을 제어하기 위해 자극 길이(단어 수)를 공변량으로 입력했습니다. 우리는 lme4 패키지(Bates et al., 2015)와 함께 R(R Core Team, 2019)을 사용했습니다.
조건의 효과가 중요한지 여부를 결정하기 위해 조건 인자를 포함하지 않는다는 점을 제외하고는 동일한 LMM과 LMM을 비교하는 우도 비율 테스트를 사용했습니다. 이러한 비교를 위해 우리는 χ2 분포(LL0 및 LL1은 축소 모델과 전체 모델의 로그 우도를 나타냄)를 따르는 검정 통계량2(LL1–LL0)와 해당 p-값. 자유도는 항상 1이었기 때문에 보고되지 않았습니다. 두 조건 사이에서 단일 참가자의 성능을 비교하기 위해 동일한 방법을 사용했지만 모델에는 참가자 및 자극 길이 요인이 포함되지 않았습니다. 무작위 요인으로 자극만 포함하고 자극 내 요인으로 조건만 포함했습니다. 효과 크기로는 모델의 조건 요인의 계수를 보고합니다. 이 계수는 조건의 평균 간의 차이에 가깝기 때문에 Δ로 표시됩니다.
결과
4명의 참가자는 7-단어 버전 작업을 수행했고 나머지 참가자는6-단어 버전 작업을 수행했습니다.

구문 청킹에 대한 단순한 예측은 자극에 문법적 부분이 더 많거나 길면 기억하기가 더 쉽다는 것입니다. 그러나 더 긴 세그먼트는 너무 길면 불리할 수 있습니다. 이러한 세그먼트로 인해 작업 메모리 용량 제한을 초과하고 기억하기 어려운 메가 청크가 생성될 수 있습니다. 따라서 세그먼트 크기와 성능 사이의 관계는 역 U자 모양을 가질 것으로 예상됩니다. 최고의 성능은 가장 긴 세그먼트가 있는 자극이 아니라 세그먼트 길이가 청크 수와 청크 크기 사이의 최적 균형을 제공하는 자극에 있어야 합니다.
너무 많고 너무 짧은 문법 세그먼트가 있는 조건은 상대적으로 작은 청크를 유도하고 비효율적인 기억 전략으로 이어질 것이며, 너무 적고 너무 긴 세그먼트가 있는 조건은 너무 크고 기억하기 어려운 덩어리의 생성을 장려할 것입니다. 그림 2에서 명확하게 알 수 있듯이 이는 정확히 사실입니다. 정확도는 조건 B에서 가장 높았고 다른 조건에서는 가장 낮았습니다. 특히 조건 B의 오류율은 조건 C보다 훨씬 높았으며 조건 D보다 오류가 훨씬 더 많았습니다. 이는 구문 청킹의 분명한 효과입니다. 즉, 참가자들은 청킹 전략에 대한 특별한 지시를 받지 못했지만 여전히 숫자의 구문 구조를 사용하고 문법적인 여러 자리 숫자를 나타내는 청크를 만들었습니다. 예상한 대로 문법 부분이 가장 긴 조건 A가 아닌, 청크 크기와 청크 개수 간의 최적의 균형을 제공하는 조건 B에서 최적의 성능이 나타났습니다.
구문 기반 청킹 아이디어에 대한 추가적인 지원은 오류가 발생한 자극 내의 특정 위치를 분석하는 것에서 비롯됩니다. 그림 3은 6- 단어 시퀀스를 반복한 참가자에 대한 각 일련 위치의 숫자 오류율을 보여줍니다(7- 단어 참가자는 길이 관련 변동을 피하기 위해 이 분석에서 제외되었습니다). 참가자가 각 자극을 구조화되지 않은 단어 순서로 기억한 경우 해당 작업은 본질적으로 자유 회상 작업입니다. 이러한 작업에서 오류율은 일반적으로 목록의 첫 번째 단어에 대해 가장 낮고 목록 아래에 있는 단어에 대해 점차 증가해야 하며(우위 효과), 마지막 단어에서 약간의 개선이 발생합니다(최근 효과, Murdock, 1962).
단편화된 조건인 조건 D는 구조화되지 않은 무료 회상 작업의 패턴을 보여줍니다. 대조적으로, 조건 A와 B는 다른 패턴을 보여주며, 이는 우선성과 최신성 효과 외에 추가적인 요인이 여기에서 작용했음을 나타냅니다. 예를 들어, 조건 B에서는 오류율이 두 번째 단어(천)에서 세 번째 단어(수백)로 감소했습니다. 각 조건의 패턴을 조사하기 위해 "천"이라는 단어(숫자가 인코딩되지 않음)를 제외하고 각 숫자에서 마지막 1000개가 아닌 단어를 제외한 6-단어 수의 각 숫자 단어의 숫자 정확도를 분석했습니다. (최근 효과를 피하기 위해).
우리는 참가자를 무작위 요인으로, 단어의 연속 위치를 숫자 참가자 내 요인으로 사용하여 각 조건의 숫자 정확도를 로지스틱 선형 혼합 모델에 개별적으로 제출했습니다. 이러한 모델은 일부 조건에서 단일 ft에 도달했기 때문에 자극을 무작위 요인으로 추가하지 않았지만 결과는 이 요인을 포함할 때 본질적으로 동일했습니다. 조건D(χ2=27.4, p)에서 단어 위치 효과가 유의하게 나타났습니다.<0.001) but only barely significant in conditions A (χ2=4.7, p=0.03) and B (χ2=4.2, p=0.04)— unimpressive significance levels that do not withstand a multiple-comparison correction. To show that the difference between conditions was significant, we submitted the data of all conditions together to the same LLMM, now adding the Condition (A/B versus D) and the Condition × Word Position interaction as within-participant factors. The interaction term was significant (χ2=11.5, p<0.001, odds ratio=0.75).
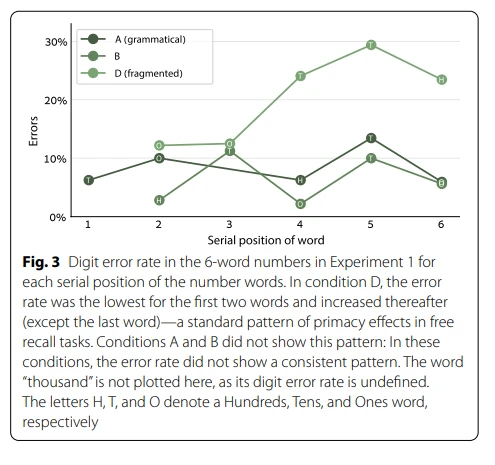
단순한 연속 회상은 조건 A와 B의 결과를 설명할 수 없지만 구문 청킹은 이 패턴에 대한 간단한 설명을 제공합니다. 조건 D에서 참가자는 각 자극을 구조화되지 않은 단어 목록으로 기억했지만 조건 A와 B에서는 각 자극을 기억하는 경향이 있었습니다. 덩어리로. 이 청킹으로 인해 작업은 단순한 연속 회상 작업이 아니므로 표준 우선 순위 및 최근 효과를 나타내지 않았습니다. 흥미롭게도 조건 A와 B에서 우월성 효과는 전체 시퀀스에 대해서만 관찰된 것이 아닙니다. 두 조건 모두에서 단어 #4의 성능이 이전 및 다음 용어보다 우수했으며 단어 4-5-6은 역의 결과를 보였습니다. U자형 패턴입니다. 이 패턴은 단어 4-5-6이 별도의 덩어리로 인코딩되어 덩어리의 첫 번째 단어와 마지막 단어에 고유한 우선성과 최신성 효과가 있다는 아이디어와 일치합니다.
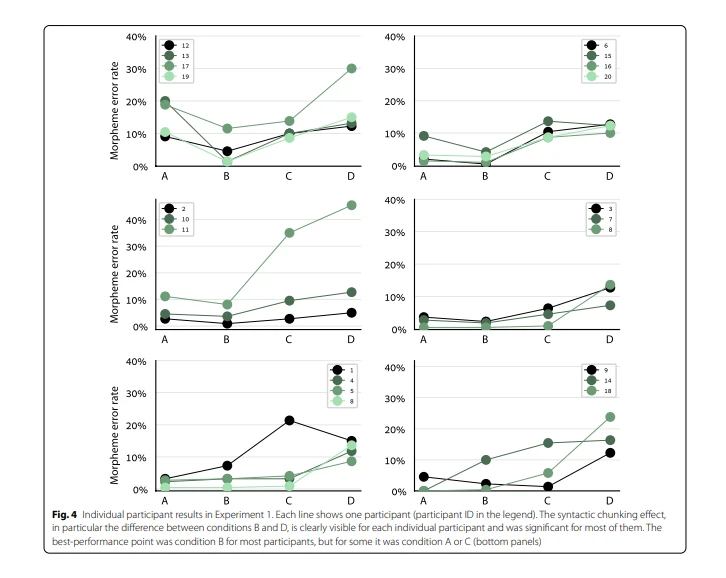
The syntactic chunking pattern—better performance in the more-fragmented conditions, and optimal performance in an interim condition—was observed not only at the group level but even for individual participants. Numerically, each of the participants showed better performance in condition B (optimal chunking) than in condition D (maximum fragmentation) (Fig. 4). This difference was significant for all participants except one (morpheme accuracy rate of each of these participants: paired t(19)>1.73, Bonferroni–Holm 수정단일 꼬리 p<0.05). Because the different conditions used the same stimuli and manipulated only the word order within each stimulus, we could also compare matched pairs of stimuli and show that a syntactic chunking effect existed even for single stimuli in most cases: Morpheme accuracy was better in condition D than in B only for 6% of the stimuli (and better in B for 63.5%; same in B and D for 30.5%). Nevertheless, the participants also differed from each other—the best-performance condition was different for different participants: For 13 participants, the optimal condition was B, but for 6 participants it was A and for one participant it was C (bottom panels in Fig. 4).

논의
최고의 성능은 각 자극이 3-단어 또는 4-단어 세그먼트의 쌍인 조건 B에서였습니다. 조건 C와 D에서는 자극에 더 많고 짧은 문법 세그먼트가 포함됨에 따라 성능이 저하되었습니다. 이러한 구문 청킹 효과는 참가자가 정수의 구문 구조에 대한 표현을 생성했으며 이 표현을 통해 점점 더 길어지는 문법 세그먼트에 대해 점점 더 긴 청크를 만들 수 있음을 나타냅니다.
가장 좋은 성능은 자극당 하나의 긴 세그먼트가 있는 조건 A가 아니라 조건 B에서였습니다. 즉, 조건 D에서 C로, C에서 B로 성능이 향상되었지만 긴 세그먼트(조건 A에서)는 기억을 방해했습니다. 이러한 결과 패턴은 효과적인 청크 생성을 위해서는 청크 크기와 청크 수 간의 최적의 균형이 필요하다는 개념을 뒷받침합니다.
조건 A에서는 참가자가 5- 또는 6- 숫자의 전체 구문 구조를 사용하여 모든 단어를 단일 청크에 저장한 것으로 보이며 이로 인해 청크 크기가 과장되어 결과적으로 기억력이 저하되었습니다. 이 견해에 따르면 오류율은 U자형 패턴을 가지고 있지만 기본 구문 청킹은 단조로운 효과를 가졌습니다. 조건 A를 포함하여 문법 세그먼트가 길수록 항상 더 큰 청크로 이어졌지만 청크 크기를 늘리는 것은 최적의 임계값 크기인 3까지만 유익했습니다. – 조건 B에서 발생한 청크당 4단어. 그 외에도 조건 A에서는 청크가 너무 커서 참가자가 효과적으로 처리할 수 없기 때문에 청크가 증가하여 성능이 저하되었습니다. 각 청크가 Cowan에 적용되는 작업 메모리 제한을 초과했습니다(2001). ). 아래 실험 5에서는 이 결론을 뒷받침하는 추가 증거를 제시합니다.
우리의 발견은 조건 A와 조건 B의 차이를 수의 크기에 귀속시키는 대안적인 해석을 반박합니다. 이 대체 해석에서는 구문 및 청킹과 관련된 이유가 아니라 조건 A의 숫자가 수치적으로 더 커서 처리하기가 더 어렵기 때문에(부작용) 조건 A의 성능이 B보다 낮았다고 가정합니다. 우리 데이터의 두 가지 측면은 대체 해석을 반박합니다. 첫째, 그림 3의 위치별 오류 패턴을 설명할 수 없습니다. 둘째, 대체 해석은 5- 또는 6- 6- 자리 숫자(조건 A에서와 같이)를 예측합니다. )은 특정 숫자에 관계없이 항상 짧은 숫자 쌍(조건 B)보다 기억하기가 더 어렵습니다. 실험 5에서 볼 수 있듯이 이 예측은 반박되었습니다.
조건 A에 비해 조건 B의 우수한 성능은 몇 가지 중요한 결론으로 이어집니다. 첫째, 숫자의 구문 표현 범위, 특히 교차 삼중 구문 표현의 범위를 보여줍니다. 조건 B, C, D에서는 단일 삼중어(백+십+일)의 경계를 넘는 문법 세그먼트가 없습니다. 이러한 조건 간의 차이는 세 단어 내 구문 표현으로 설명될 수 있습니다. 예를 들어 각 세 단어의 세 단어가 서로 다른 어휘 클래스를 갖는다는 사실을 활용하는 표현입니다. 조건 A와 B에서는 상황이 달랐습니다. 이 두 조건 사이의 유일한 차이점은 조건 B가 아닌 조건 A가 두 세 쌍의 단어를 단일 세그먼트로 결합했다는 것입니다. 두 조건 간의 중요한 차이는 조건 A에서는 있지만 조건에서는 그렇지 않음을 나타냅니다. B, 참가자들은 삼중항 간 구문 표현을 만들었습니다. 일반 토론에서 우리는 이 자금의 의미로 돌아갑니다.
두 번째 결론은 자동성에 관한 것입니다. 조건 A에서는 유익하지 않음에도 불구하고 삼중 교차 구문 표현이 생성되어 성능을 저하시켰습니다. 이는 구문적 표현의 생성이 자발적이고 의식적인 전략적 결정에서 나온 것이 아니라 자동적인 과정이었다는 것을 강력하게 시사합니다.
세 번째 결론은 구문 표현이 엄격한 템플릿으로 검색되는지 아니면 생성 프로세스에 의해 동적으로 생성되는지에 관한 것입니다. Cowan(2001)은 청크를 생성하는 데 최소한 두 가지 다른 방법이 있다고 제안했으며, 이 두 방법은 청크 크기에 부과하는 제한이 다릅니다. 한 가지 방법은 덩어리의 기초 역할을 하는 기억된 템플릿을 검색하고 이 템플릿에 여러 단일 항목을 포함하는 것입니다(각 단일 항목은 장기 기억의 표현입니다). 예를 들어, 전문 체스 플레이어가 복잡한 동작을 인코딩하는 방법이 될 수 있습니다. 이러한 템플릿의 항목 수는 때때로 표준 단기 메모리 용량인 3~4개 항목보다 훨씬 클 수 있지만 템플릿은 여전히 단일 청크입니다. 청크를 생성하는 두 번째 방법은 항목 간에 새로운 임시 연결을 형성하는 것입니다. 이 방법은 더 동적이고 유연하지만 청크 크기가 작업 메모리 용량 제한인 3~4개 항목에 따라 비용이 발생합니다. 중요한 점은 이 두 가지 방법이 청크 크기에 적용하는 제한이 다르다는 것입니다. 후자의 방법은 작업 메모리 용량 제한이 적용되는 반면 전자는 그렇지 않습니다. 따라서 우리 실험에서 구문 청크가 생성 방식으로 생성되면 작업 메모리 용량 제한이 적용되어 대형 청크에서 성능이 저하됩니다. 이는 조건 A에서 볼 수 있는 패턴과 정확히 같습니다. 템플릿을 사용하면 참가자는 용량 제한이 적용되지 않는 템플릿 기반 청크를 만들 수 있었고 조건 A(자극당 1개 청크)의 성능은 조건 B(자극당 2개 청크)보다 더 좋았어야 했습니다. 사례. 따라서 우리는 숫자의 구문 구조가 미리 정의된 기억된 템플릿으로 검색된 것이 아니라 실시간 생성 프로세스에 의해 생성되었다고 결론지었습니다.
구문 청킹은 실제로 구문 표현을 나타냅니다.
효율적인 청킹에는 자극의 두 가지 주요 측면, 즉 감지 가능성과 압축성이 포함됩니다(Chekaf et al., 2016). 첫 번째 측면은 자극의 규칙성을 감지하는 것과 관련되며, 이는 예를 들어 최적의 청크 경계를 설정하여 효과적인 청킹 기회를 제공합니다. 우리의 경우 이는 문법적 부분의 감지를 의미합니다. 두 번째 측면은 아마도 청크의 요소들 사이의 강력한 연관성을 가진 일부 표현에 의존하여 데이터를 청크로 압축하는 프로세스를 나타냅니다(Cowan, 2001). 우리의 경우 압축성은 아마도 숫자 구문의 표현에 의해 결정됩니다.
우리는 압축성 측면에서 실험 1 결과를 해석했습니다. 실험 조건 간의 중요한 차이점은 구문 기반 청크를 생성하는 참가자의 능력에 영향을 미친다는 것입니다. 그러나 문법 부분의 탐지 가능성에 있어서 조건이 서로 다를 수 있습니까? 실험 1에서 우리는 의도적으로 청킹에 대한 단서를 제공하지 않았지만(탐지 가능성에 영향을 미칠 수 있는 단서를 제공하지 않기 위해), 그러한 단서가 없는 경우 참가자는 서로 다른 감지 가능성 수준을 무관심한 조건으로 초래할 수 있는 다른 전략에 의지했을 수 있습니다. . 예를 들어, 그들은 각 단어 뒤에 "청크 닫기"와 같은 간단한 전략을 사용했을 수 있습니다. 이 전략은 조건 D보다 조건 B에서 더 효율적인 청킹 결과를 가져올 수 있습니다. 대안으로 그들은 형식적인 수학적 지식을 기반으로 하는 명백한 전략을 사용했을 수도 있습니다. 그리고 그러한 전략은 아마도 참가자의 숫자에 대한 공식적인 지식에 더 잘 맞는 문법적 조건에서 구현하기가 더 쉬울 수 있습니다. 탐지 가능성의 효과는 실험 1의 차단 설계에 의해 더욱 증폭되었을 수 있으며, 이를 통해 각 블록에서 조건별 전략을 개발할 수 있습니다.
실험 1의 조건 A와 B 사이의 비교는 이것이 사실이 아님을 암시합니다. 왜냐하면 참가자들은 이것이 효과가 없더라도(조건 A에서) 구문 표현을 생성했기 때문입니다. 그럼에도 불구하고 우리는 대체 해석을 구체적으로 반박하기 위해 실험 2와 3을 설계했습니다. 실험 2에서는 블록별 전략을 억제하기 위해 혼합 설계를 사용했습니다. 실험 3에서는 조건 간의 탐지 가능성 차이를 최소화하기 위해 청크 경계에 대한 명확한 단서를 제공했습니다.
실험 2: 혼합 설계
설계는 실험 1과 유사했지만 여기서는 서로 다른 조건이 단일 블록에 혼합되었습니다. 이 디자인은 참가자가 특정 자극이 실행될 때까지 특정 자극의 구문 구조를 알 수 없기 때문에 명백한 전략을 사용하기 어렵게 만들어야 합니다. 따라서 실험 2의 구문 청킹 효과는 과도한 전략의 결과로 설명하기 어려울 것입니다.

방법
자극당 2, 3 또는 4개의 문법 세그먼트가 있는 3가지 조건이 있었고 각 조건에는 각각 4, 9 및 7번의 시도가 있었습니다. 모든 시험 유형은 단일 블록에 무작위 순서로 제시되었습니다(모든 참가자에게 동일한 순서). 참가자들은 실험 1을 수행한 사람들과 동일했습니다. 그들은 실험 1 직전이나 직후에 실험 2를 수행했습니다("구문 청킹 작업" 섹션 참조). 각 참가자는 실험 1과 같이 6- 단어 또는 7- 단어 버전 작업을 수행했습니다. 데이터 코딩 및 통계 분석은 실험 1과 동일했지만 선형 혼합 모델에서는 조건 요인이 자극 내 범주형 요인이 아닌 자극 간 수치 요인입니다. (아직도 참가자 내였습니다.)
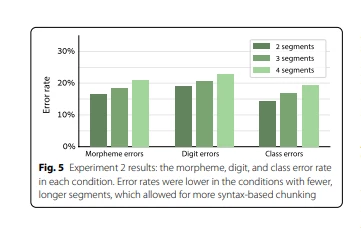
결과 및 토론
실험 1의 결과는 기본적으로 복제되었습니다. Te 성능은 더 적고 더 긴 세그먼트가 있는 조건에서 더 좋았습니다(그림 5). 선형 혼합 모델에서는 조건 효과가 형태소 오류율(Δ=2.2%, χ2=4.17, p=0.04)과 클래스 오류율(Δ)에서 유의미한 것으로 나타났습니다. =2.5%, χ2=5.09, p=0.02), 단, 숫자 오류율(Δ=1.9%, χ{{16} }.48, p=0.12).
이러한 결과는 명백한 전략으로 설명하기 어렵습니다. 이러한 명백한 전략이 효과적이려면 참가자는 각 시도에서 전략을 결정해야 했고, 자극이 적용된 후에만 전략을 결정해야 했으며 이때 이미 암기 도전이 시작되었습니다. . 더 좋고 그럴듯한 설명은 구문적 청킹으로 인해 문법적 조건이 유리했다는 것입니다.
실험 3: 명백한 신호
이 실험은 특히 구문적 청킹 효과에 대한 설명으로 문법적 세그먼트 감지 가능성을 배제하는 것을 목표로 했습니다. 이를 위해 우리는 모든 조건에서 가능한 한 쉽게 탐지 가능성을 문제가 되지 않도록 만들었습니다. 참가자들에게 단어 시퀀스를 덩어리로 분할하는 방법에 대한 명확하고 명시적인 단서를 제공했습니다. 실험 1의 조건 간의 차이가 문법 세그먼트의 감지 가능성에서 비롯된 경우, 명백한 단서는 미묘한 자극별 차이를 무시해야 하며 성능은 조건 전체에서 유사해야 합니다. 그러나 실험 1의 결과가 문법 부분의 압축률이 높아져서 나온 결과라면 여기에도 결과를 재현해야 합니다.
방법
참가자는 19;6~52;7(평균=27;7, SD=7;9) 사이의 성인 20명이었습니다. 실험에는 실험 1 조건 B(문법적) 및 D(단편화)와 동일한(동일한 자극) 두 가지 조건만 포함되었습니다. 모든 참가자는 7-단어 버전의 작업을 수행했습니다. 조건은 균형 잡힌 순서로 두 블록으로 관리되었습니다. 절차는 청크 경계에 대한 명확한 단서를 제공한다는 점을 제외하면 실험 1과 동일했습니다. 비판적으로, 단서는 두 조건(문법적 및 단편적)에서 동일했습니다. 두 경우 모두 참가자는 각 자극을 두 개의 덩어리, 즉 3개 단어와 4개 단어로 분할하라는 신호를 받았습니다. 문법 조건에서 단서는 자극을 { {14}}숫자 1로 시작하고 뒤에 3-자리 숫자가 오는 숫자입니다(예: 천이백삼십사, 오백육십오). 단편화된 조건에서 단서는 자극을 동일한 길이의 두 부분으로 분할했지만 어느 부분도 문법적이지 않았습니다. 문법적으로 유효한 단어 쌍(5600개, 430만개)을 피하기 위해 단어의 순서가 반대였습니다.
신호로서 우리는 억양의 두 가지 측면을 사용했습니다. 첫째, 실험자는 실험 1에서와 같이 고정된 속도로 숫자 단어를 말하지 않았지만 두 숫자를 말하듯이 각 자극 부분 내의 단어 사이에는 지연이 없었고 자극의 두 부분 사이에는 약 1초의 지연이 있었습니다. 둘째, 각 자극부분의 마지막 단어는 내림차순(문장 마지막 단어의 전형적인 억양)으로 말하였고, 앞의 단어들은 모두 굵은 억양으로 말하였다. 이러한 단서에 대한 주의를 돕기 위해 실험 1에서와 같이 자극을 녹음하여 재생하지 않고 실험자가 실시간으로 말했습니다. 데이터 코딩 및 통계 분석은 실험 1과 같습니다.
결과 및 토론
실험 1의 결과는 기본적으로 재현되었습니다. Te 형태소 오류율, 숫자 오류율 및 클래스 오류율은 단편화 조건보다 문법 조건에서 더 낮았습니다(그림 6a; 실험 1 "통계 분석" 섹션에 설명된 LMM 사용, 형태소: Δ=12.3%, χ2=140.5, p<0.001; digits: Δ=12.1%, χ2=136.1, p<0.001; classes: Δ=10.8%, χ2=103.8, p<0.001). Even at the single-subject level, the morpheme error rate was lower in the grammatical condition than in the fragmented condition for every single participant (Additional file 1: Fig. S2).
각 자극을 두 개의 덩어리로 나누는 방법에 대한 매우 명확한 단서를 제공했지만 존재했던 두 조건 간의 차이는 두 조건에서 문법적 세그먼트 감지 가능성의 정도가 다르기 때문에 발생했을 가능성이 없습니다. 이러한 결과에 대한 가장 가능성 있는 해석은 유효한 숫자 구문을 사용하여 문법적 조건이 숫자-단어 시퀀스의 더 높은 압축성을 허용한다는 것입니다.
실험 4: 구문적 표현은 다양한 불규칙 구조를 처리할 수 있습니다.
실험 1~3에서는 참가자가 숫자의 구문 구조를 나타내고 이를 청킹의 기초로 사용했음을 보여주었습니다. 실험 4에서는 이 구문 표현의 두 가지 추가 측면을 조사했습니다. 범위, 즉 표현할 수 있는 특정 구문 구조와 유연성, 즉 한 구문 구조에서 다른 구문 구조로 빠르게 전환하는 능력입니다. 이를 위해 우리는 여러 가지 다른 구문 구조를 가진 숫자를 포함했습니다.
범위. 실험 1-3에서는 제한된 범위의 숫자를 사용했습니다. 모든 자극은 0도 1도 포함하지 않은 숫자를 기반으로 했습니다. 이 디자인은 0와 1이 있는 숫자에서 발생할 수 있는 복잡성을 피하는 것을 목표로 했습니다. 불규칙한 구문 구조로 동사 숫자 생성: 히브리어에서 영어와 유사하게 숫자 0는 구두로 인식되지 않으며, 10진수 위치의 숫자 1은 표준 10 단어 대신 10대 단어로 구두로 인식됩니다. 0과 1을 피함으로써 실험 1-3에는 규칙적인 구문 구조를 가진 숫자만 포함되고 불규칙 구조를 가진 숫자는 포함되지 않았습니다. 대조적으로, 실험 4에서는 불규칙한 숫자에 대해서도 구문 표현이 생성되는지 여부를 조사했습니다.

유연성. 우리가 조사한 두 번째 측면은 구문 메커니즘의 유연성입니다. 실험 1과 3에서는 주어진 블록의 모든 숫자가 동일한 구문 구조를 가졌습니다. 실험 2는 혼합된 디자인을 가지고 있었지만 구문 구조의 작은 다양성만 사용했습니다. 실험 4에서는 더 많은 구문 구조를 사용하고 이를 무작위 순서로 제시했기 때문에 구문 표현과 이를 생성하는 프로세스가 더 까다로운 시나리오에서도 구문 청킹의 기초 역할을 할 만큼 충분히 유연한지 여부를 조사할 수 있었습니다.
For more information:1950477648nn@gmail.com