야생에서 보행 인식을 위한 자가 감독 비전 변환기 탐색 3부
Nov 24, 2023
우리는 인접한 관절 사이를 보간하기 위해 간단한 업샘플을 사용합니다(그림 3). 그러나 뼈대에 대해 순진하게 그렇게 하면 뼈대 형식(예: OpenPose 또는 COCO)의 선택에 관계없이 뼈대 전체에 허위 관절이 생성됩니다. 관절 순서가 의미론적 의미를 유지하지 않기 때문입니다.
관절 순서화(Joint Sequencing)란 신체의 관절을 특정 순서에 따라 움직이는 것을 말합니다. 이러한 유형의 운동은 신체 건강을 유지하고 신체 기억력을 향상시키는 데 중요한 역할을 합니다.
우선, 관절 순서화는 신체의 다양한 부위의 조화로운 움직임을 촉진하고 근력을 강화하며 심폐 기능을 향상시켜 건강을 유지하는 데 도움이 됩니다. 동시에 규칙적인 관절 정렬은 몸의 경직과 통증을 감소시키고, 자세와 균형을 개선하며, 노화로 인한 신체 기능 저하를 지연시킬 수 있습니다.
둘째, 공동 시퀀싱은 기억력을 향상시킬 수도 있습니다. 연구에 따르면 운동은 뇌 뉴런의 성장과 연결을 자극하여 뉴런 간의 정보 교환을 촉진하여 기억력과 학습 능력을 향상시키는 데 도움이 될 수 있습니다. 관절의 순차적인 움직임을 위해서는 뇌가 신체의 다양한 부분의 움직임에 대해 정확한 지시를 내려야 하는데, 이는 뇌의 협응력과 기억력 발달에 큰 도움이 됩니다.
마지막으로, 관절 순서 분석은 스트레스와 불안을 완화하고 정서적 안정성을 향상시킬 수도 있습니다. 운동은 도파민, 엔돌핀과 같은 신체의 일부 물질을 방출하여 정서적 문제를 완화하고 신체의 행복감과 만족감을 향상시키는 데 도움이 될 수 있습니다. 이러한 요소는 기억력 향상에도 긍정적인 영향을 미칩니다.
요약하면, 관절 순서와 기억 사이에는 긍정적인 관계가 있습니다. 규칙적인 관절 순서 운동을 통해 건강한 신체와 두뇌 발달을 촉진하고 기억력과 학습 능력을 향상시키며 정서적 안정을 향상시킬 수 있습니다. 건강에 유의하고 함께 삶의 아름다움을 즐기자! 기억력 향상이 필요함을 알 수 있는데, 시스탄체 데저티콜라는 기억력 향상이라는 독특한 효능이 많은 중국 전통 약재이기 때문에 기억력을 크게 향상시킬 수 있습니다. 다진 고기의 효능은 산, 다당류, 플라보노이드 등 포함된 다양한 활성 성분에서 비롯됩니다. 이러한 성분은 다양한 방식으로 뇌 건강을 증진할 수 있습니다.

이 관찰은 Yang et al.의 연구와 일치합니다. [44]는 관절 사이의 공간적 관계를 제안하기 위해 TSSI(Tree Structure Skeleton Image)를 제안한다. 이는 뼈대의 구조적 정보를 보존하는 관절의 깊이 우선 트리 순회 순서를 기반으로 합니다. 그림 3(오른쪽)은 다양한 뼈대 형식과 업샘플링 방법의 효과를 보여줍니다. 이 크기 조정 방법에는 TSSI 형식과 쌍삼차 보간법을 사용했습니다.
또한 훈련 중에 학습할 수 있는 두 가지 업스케일링 방법을 실험했습니다. 우리는 관절 수를 늘리기 위해 평평한 각 뼈대에 간단한 선형 레이어를 적용했습니다. 이는 각 골격을 변환하는 가장 간단한 방법이지만 관절 간의 공간 관계를 설명하지 않습니다. 이 문제를 해결하기 위해 우리는 구조적 정보를 고려하면서 크기 조정을 위해 뼈대 시퀀스에 2D 디콘볼루션 레이어 세트도 사용합니다. 이 방법에서는 TSSI 형식도 사용합니다.
표 1은 모든 아키텍처에 대한 각 크기 조정 방법의 결과를 보여줍니다. 모델은 CASIA-B에서 200세대 동안 훈련 및 평가되었으며 일반 보행에 대한 결과를 보여줍니다. 나머지 실험에서는 쌍삼차 보간법을 사용하여 골격 시퀀스를 업샘플링하기로 결정했습니다.


몇 가지 가능한 자가 감독 사전 훈련 절차가 있지만, 보행 인식의 실제 검색 작업에 대한 절차와 동일한 절차이기 때문에 대조 사전 훈련 접근 방식을 선택했습니다. 대조적 접근 방식은 동일한 클래스에 속하는 표현이 잠재 공간에서 가까워지는 동시에 다른 클래스에 속하는 표현과는 멀리 떨어져 있도록 장려합니다.
특히 사전 훈련에는 Supervised Contrastive [45]를 사용합니다. SupCon 손실은 다중 보기 배치에서 작동합니다. 배치의 각 샘플에는 자체적으로 여러 개의 증강 버전이 있습니다. 이는 데이터 손상에 대해 자연스럽게 더 강력한 것으로 나타났으며, 경사도가 어려운 예로부터 학습을 장려하고 하이퍼파라미터에 덜 민감하기 때문에 삼중항을 신중하게 선택할 필요성을 완화합니다.

3.4. 데이터 증대
SupCon 손실을 통한 자가 감독 대조 방식의 훈련은 동일한 뼈대 시퀀스에 대해 여러 개의 증강된 "보기"를 제공하기 위한 데이터 증강의 사용을 의미합니다. 걷는 뼈대 시퀀스에 사용되는 증강은 이 분야의 다른 작업과 일치합니다[10,12, 30]. 사용된 주요 확대는 T=64 프레임의 기간 길이를 갖는 무작위 시간 자르기입니다.
뼈대가 다양한 기간 동안 추적된다는 점을 고려하여 자르기를 사용하여 모든 시퀀스의 길이가 동일하도록 합니다. 게다가 걷는 사람은 추적 기간 동안 방향을 바꾸고 다른 작업을 수행할 수도 있습니다. 결과적으로 자르기는 동일한 시퀀스에 대해 더 많은 가변성을 유도합니다.
또한 걷기 속도를 늦추거나 높여 걷는 속도를 수정했습니다. 속도 수정자는 {{{0}}.5, 0.75, 1, 1.25, 1.5, 1.75, 2.0}. 이는 Wang et al.의 연구에서 채택되었습니다. 비디오 표현의 자기 지도 학습을 위한 것입니다. 더욱이, 과거에는 보행 분석에 속도 수정이 사용되었습니다[33].
또한 확률이 {{0}.5인 무작위 뒤집기, 확률이 0.5인 시퀀스 역전, σ=0.005인 각 관절에 대한 추가 가우스 노이즈를 사용합니다. 자세 추정 모델에서 누락된 관절을 시뮬레이션하기 위해 0.01의 확률로 관절의 5%를 무작위로 삭제합니다.

3.5. 초기화 방법
제안된 아키텍처에 대한 자기 감독 사전 훈련 성능의 영향을 측정하기 위해 세 가지 다른 초기화 방법을 탐색합니다. 표 2는 문헌에 사용된 다양한 데이터 세트를 보여줍니다. CASIA-B [6] 및 FVG[29]는 주로 평가에 사용되는 제어된 데이터 세트인 반면, 5가지 아키텍처에 대한 자체 지도 사전 학습에는 DenseGait [12] 및 GREW [7]를 사용합니다. DenseGait과 GREW는 야외 환경에서 수집된 가장 큰 실제 보행 데이터베이스 중 두 가지로, 아마도 일상 생활에 존재하는 대부분의 보행 변형, 행동 및 복잡성을 포함하고 있을 것입니다. 우리는 일반적인 감시 시나리오에서 보행 인증을 허용하기 위해 보다 일반적인 보행 표현을 갖도록 이러한 데이터 세트를 선택합니다.

DenseGait 사전 훈련 DenseGait은 감시 스트림에서 자동으로 수집된 대규모 "야생" 보행 데이터 세트입니다. 여기에는 여러 지리적 위치의 다양한 환경과 카메라 각도에서 AlphaPose[22]를 사용하여 추출된 217K 추적 뼈대 시퀀스가 포함되어 있습니다. DenseGait은 자동으로 수집되므로 추적 식별자 측면에서 주석에 잡음이 많으며 데이터 세트에 동일한 주제에 대한 시퀀스가 포함될 수 있지만 이는 드문 일입니다. 그러나 이는 동일한 의미 클래스에 속하는 샘플을 포함하는 대부분의 레이블이 지정되지 않은 대규모 데이터 세트의 경우이며 훈련 중에 관련 없는 것으로 간주됩니다. 우리는 DenseGait에서 각 아키텍처를 사전 훈련하고 훈련된 매개변수를 사용하여 제어된 데이터 세트의 추가 다운스트림 성능 평가를 수행합니다.
GREW 사전 훈련 GREW는 또 다른 야외 "야생" 데이터 세트이지만 여러 날에 걸쳐 걷는 대상과 다양한 유형의 옷을 포함하도록 주의 깊게 주석이 추가되었습니다. 그러나 자체 감독 체제의 요구 사항을 준수하기 위해 주석을 삭제하고 각 걷기 시퀀스를 별도의 사람으로 처리합니다. GREW는 DenseGait보다 2배 작으며 128K 뼈대 시퀀스를 포함하고 각 보행자를 더 짧은 평균 기간 동안 추적합니다[12]. 또한 GREW에서 각 아키텍처를 교육하고 다운스트림 성능 평가를 위해 교육된 매개변수를 사용합니다.
무작위 초기화 이 초기화 방법은 사전 훈련이 없는 것(즉, 처음부터 훈련)에 해당합니다. 각 아키텍처는 다운스트림 데이터세트에서 무작위 가중치 초기화를 통해 훈련됩니다. 이 방법은 사전 훈련을 통해 성능 향상을 비교하기 위한 기준입니다.
3.6. 평가
하류 작업 성능은 보행 인식을 위해 두 가지 다른 방식으로 평가됩니다. 특정 작업을 위해 미세 조정하지 않고 사전 학습된 아키텍처의 검색 기능을 직접 테스트합니다. 이 방법은 제로샷 전송에 해당합니다. 또한, 계층별 학습률 감쇠(LLRD) [50] 정책에 따라 네트워크 시작 부분에서 점진적으로 더 작은 학습률을 사용하여 사전 학습 중보다 10배 더 작은 학습률을 사용하여 각 아키텍처를 미세 조정합니다.
다운스트림 성능 평가는 두 가지 인기 있는 보행 인식 데이터 세트인 CASIA-B [6] 및 FVG [29]에서 수행됩니다. 두 데이터세트 모두 카메라 각도, 의복, 액세서리, 보행 속도 등 다양한 교란 요인에 따라 제어되는 엄격한 걷기 프로토콜에 따라 소수의 주제를 특징으로 합니다.
CASIA-B는 11개의 동기화된 카메라에서 캡처한 124개의 피사체가 포함된 실내 데이터세트입니다. 각 개인은 일반 걷기, 옷 갈아입기, 가방 들고 걷기 등 세 가지 다른 조건으로 걷습니다. 출시 이후 보행 분석 모델을 벤치마킹하는 데 필수 요소였으며 이 분야에서 가장 많이 사용되는 데이터 세트 중 하나입니다. 처음 62명의 대상을 훈련 세트로 사용하고 나머지 62명의 대상을 성과 평가에 사용합니다. 보행 인식을 위해 우리는 갤러리 세트에 프로브 각도를 제외한 모든 보행 각도가 포함되어 있는 "leave-one-out" 설정에서 각도별로 성능을 평가하기로 선택했습니다.
Front-View Gait는 보행 인식을 위한 또 다른 인기 있는 데이터 세트로, 226명의 피험자가 다양한 프로토콜에 따라 야외에서 걷고 있습니다. CASIA-B와 달리 FVG는 걷는 속도, 어수선한 배경, 시간의 흐름(즉, 일부 피험자는 1년에 걸쳐 걷기를 등록했습니다)과 같은 추가 교란 요인을 제공합니다. 또한, 모든 피사체는 전방 카메라 각도로 촬영되는데, 이는 인식되는 관절 움직임 변화량이 가장 적기 때문에 보행 인식에 가장 어려운 각도로 간주됩니다. 처음 136개 과목을 훈련에 사용하고 나머지는 성과 평가에 사용했습니다. 보행 인식에 대한 성능 평가는 저자가 설명한 프로토콜을 준수하며 갤러리 세트에서는 일반적인 걷기 순서를 사용하고 프로브 세트에서는 기타 조건을 사용합니다.

모든 평가 시나리오에서 우리는 걷기 시퀀스의 중심에서 결정적 자르기를 사용하고 테스트 시간 확대를 사용하지 않습니다.
4. 실험 및 결과
4.1. CASIA-B의 평가
우리는 각각 DenseGait과 GREW에 대한 각 아키텍처를 사전 훈련하고 CASIA-B와 FVG에 대한 성능을 평가합니다. 첫 번째 실험 세트에서는 점진적으로 더 큰 훈련 샘플을 사용하여 사전 훈련 후 미세 조정 시나리오에서 CASIA-B의 성능을 평가하는 데 관심이 있습니다. 우리는 사용 가능한 모든 걷기 변형을 포함하여 처음 62개의 ID에 대해 각 네트워크를 훈련하고 나머지는 테스트용으로 보관했습니다. 인식 평가는 처음 4개의 일반 보행 샘플을 갤러리 세트로 사용하고 나머지는 프로브 세트로 사용하여 수행되었습니다. 그림 4는 CASIA-B에 대한 세 가지 걷기 변형(일반 - NM, 의복 - CLm 및 휴대용 가방 - BG) 각각에 대한 정확도를 보여줍니다. 이 시나리오에서는 주제별, 각도별로 K={1, 2, 3, 5, 7, 10}개의 걷기를 무작위로 샘플링하고 모델을 훈련했습니다. 성능은 아키텍처 간에 상대적으로 유사하지만 다음은 분명합니다. 사전 훈련은 사전 훈련 데이터 세트 선택에 관계없이 무작위 초기화에 비해 성능이 크게 향상됩니다.
또한 SimpleViT, CrossFormer 및 Twins-SVT는 비슷한 높은 성능을 보이는 반면 Token2Token은 약간 뒤떨어져 있습니다. 이는 이미지와 같은 구조를 위해 특별히 설계된 Token2Token에서 사용되는 점진적 토큰화 방법이 보행 시퀀스의 특성을 효과적으로 포착하지 못한다는 것을 의미합니다. 사전 훈련 데이터 세트 간에는 눈에 띄는 차이가 있습니다. DenseGait은 GREW와 비교할 때 두 가지 걷기 변형(CL 및 BG)에서 일관된 성능 향상을 제공하는 것으로 보입니다. 이는 DenseGait에 보행 패턴이 외부 요인의 영향을 받는 조건에 대해 모델을 더 잘 준비하는 더 도전적이고 현실적인 시나리오가 포함되어 있다는 사실을 나타냅니다.


아키텍처는 걷기 시퀀스를 임베딩 공간에 매핑하도록 훈련되었으며, 여기서 포인트 간의 근접성은 해당 걷기 시퀀스의 유사성을 반영합니다. 이는 동일한 ID의 보이지 않는 보행 시퀀스 임베딩이 임베딩 공간에서 서로 가까워 클러스터를 형성해야 하는 반면, 서로 다른 ID의 임베딩은 서로 더 멀리 떨어져 별개의 클러스터를 형성해야 함을 의미합니다. 이는 모델이 보이지 않는 보행 시퀀스를 일반화하고 최근접 접근 방식을 사용하여 개인을 정확하게 식별할 수 있도록 해주기 때문에 중요합니다. 그림 5에서는 t-SNE를 사용한 차원 축소 후 CASIA-B 테스트 세트의 각 ID에 대한 임베딩에 대한 클러스터링을 제시합니다[51]. 우리는 256-차원 임베딩 벡터를 사용하여 이를 2차원으로 투영했습니다. SimpleViT와 CrossFormer는 카메라 시점에 관계없이 아이덴티티를 가장 잘 분리한 것 같습니다.

4.2. FVG 평가
마찬가지로 단일 시야각만 포함한다는 점에서 CASIA-B와 질적으로 다른 FVG에서 각 아키텍처의 성능을 평가했습니다. 우리는 분수 f={0.1, 0.2, 0.3, {{10에 대해 사전 훈련된 각 네트워크를 미세 조정했습니다. }}.5, 0.7, 1.0} 훈련 세트에서 개인당 12번 실행됩니다. 미세 조정 결과는 그림 6에 나와 있습니다. 결과는 CASIA-B의 결과와 유사한 추세를 따릅니다. SimpleViT 및 CrossFormer는 지속적으로 높은 성능을 가지며 사전 훈련 데이터 세트를 사용하면 다운스트림 성능에 유리합니다. 또한 DenseGait에 대한 사전 훈련은 지속적인 정확도 향상을 가져오는 것으로 보입니다. Cosma와 Radoi[12]가 언급한 것처럼 DenseGait에는 더 오랜 기간 동안 추적된 대상이 포함되어 있으며 이는 자연 이미지에 대한 자기 감독 사전 훈련을 위한 무작위 자르기와 유사하게 대조 학습 목표에 더 많은 변형을 제공합니다. CASIA-B의 결과와 유사하게 의복 변형은 일반적인 걷기 시나리오보다 심각하게 지연됩니다.
표 4에서는 CASIA-B 시나리오와 유사하게 사전 훈련된 모델 간의 FVG 테스트 세트에 대한 보다 세분화된 결과를 제시합니다. 사전 훈련 결과는 일관됩니다. DenseGait에 대한 사전 훈련은 다운스트림 정확도의 향상과 직접적인 상관 관계가 있습니다. 두 데이터 세트에 대한 사전 교육은 모든 시나리오에서 성능을 향상시키지만, 현실 설정에서 예상되는 것과 유사하게 일반적으로 비디오에 더 많은 사람이 포함되는 CBG(Cluttered Background) 시나리오에서 개선이 특히 중요합니다. 이러한 개선은 DenseGait과 GREW가 통제되지 않은 자연 환경에서 수집되어 더욱 현실적이고 도전적이게 만들어 CBG 시나리오와 유사한 조건에 대한 모델을 더 잘 준비한다는 사실에서 비롯된 것 같습니다. 모델 간 순위는 CASIA-B와 유사합니다. SimpleViT, CrossFormer 및 Twins-SVT는 지속적으로 CaiT 및 Token2Token보다 성능이 뛰어납니다. CASIA-B와 FVG 모두 CaiT는 다른 모델보다 약간 뒤떨어집니다.

4.3. 시공간 민감도 테스트
비전 트랜스포머의 한 가지 특징은 패치 크기를 임의로 선택할 수 있다는 점인데, 이는 최종 성능에 결정적인 영향을 미칠 수 있습니다. 이미지 처리의 경우 이미지의 의미 콘텐츠의 변환 불변성으로 인해 패치 크기는 특별히 중요하지 않습니다.
그러나 뼈대 시퀀스의 경우 패치 차원은 입력의 구체적이고 해석 가능한 특징에 해당합니다. 패치 높이는 패치에 포함된 공간 정보의 양(예: 포함된 골격 관절 수)을 나타내고, 시간 차원은 포함된 시간 정보의 양을 나타냅니다( 즉, 프레임 수). 보행 분석을 위해 적응형 비전 변환기를 사용할 때는 둘 사이의 균형을 신중하게 고려해야 합니다. 그림 7에서는 모든 셀이 정상적인 걷기에 대해 CASIA-B에서 훈련된 모델(무작위로 초기화됨)의 성능인 히트맵을 보여줍니다. 공정한 비교를 위해 각 모델을 50세대 동안 훈련하고 고정된 단계 수에서 수렴 속도를 측정합니다.
기본 백본이 비슷하고 패치 크기를 수정하는 것이 간단하기 때문에 SimpleViT용과 CaiT용으로 두 개의 히트맵을 구성했습니다. 테스트된 다른 아키텍처에 대해서도 동일한 프로세스를 수행할 수 있습니다. 우리는 더 작은 패치 크기가 뼈대 시퀀스에 대한 모델링 성능의 긍정적인 증가에 해당하는 반면, 성능이 유사하기 때문에 공간적 차원과 시간적 차원 사이의 균형은 중요하지 않다고 결론지었습니다. 히트맵 행렬은 두 번째 대각선에 의해 상당히 대칭입니다. 따라서 공간적 및 시간적 차원에 걸쳐 (2, 4)와 같은 작은 정사각형 패치 크기가 이 작업에 가장 적합한 반면, (32, 32)와 같은 큰 패치 크기에는 식별 정보가 너무 적습니다. 그러나 패치 크기가 작을수록 패치 수가 늘어나므로 더 많은 컴퓨팅 성능이 필요합니다. 2개의 NVIDIA RTX 3060 GPU 설정에서 더 작은 패치 크기의 일부 조합에 대한 메모리 부족 오류를 보고했습니다.
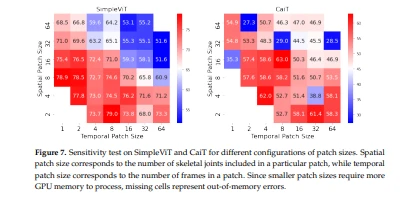
더 작은 패치 크기로 성능이 향상되는 가장 가능성 있는 이유는 아키텍처가 패치 간의 보다 복잡한 상호 작용을 계산하여 걷기 패턴의 복잡성을 더 잘 포착할 수 있기 때문입니다. 가능한 가장 큰 공간 크기와 가장 작은 시간적 크기를 가진 패치는 골격의 완전한 표현으로 간주될 수 있는 반면, 가능한 가장 큰 시간적 크기와 가장 작은 공간적 크기를 가진 패치는 개별 관절의 움직임 전체를 포착합니다. 관찰할 수 있듯이, 패치 크기가 밀접하게 연결된 관절의 작은 움직임에 해당하는 공간적 및 시간적 정보의 균형을 통합할 때 가장 높은 정확도가 달성됩니다.
5. 논의 및 결론
이 작업에서 우리는 스켈레톤 시퀀스 처리에 적합한 비전 변환기의 5가지 인기 변형에 대한 포괄적인 평가를 제공했습니다. 우리의 노력은 변환기 아키텍처에서 다양한 양식을 본질적으로 통합하려는 딥 러닝의 최근 발전과 일치합니다. 우리는 관절 수를 인위적으로 늘려 트랜스포머 인코더에서 시퀀스를 적절하게 사용할 수 있도록 뼈대에 대한 공간 업샘플링(TSSI 뼈대 형식의 바이큐빅업 샘플링) 방법을 제안했습니다. 또한 각 아키텍처는 두 개의 일반 및 대규모 보행 데이터 세트(예: DenseGait 및 GREW)에 대한 자체 감독 훈련 패러다임에 따라 훈련되었으며, 이후 통제된 환경에서 보행 인식을 위한 두 개의 데이터 세트(예: CASIA-B 및 FVG)에 대해 평가되었습니다. 우리는 특정 보행 변형이나 카메라 시점에 제한되지 않고 일반적인 보행 기능을 얻기 위해 자기 지도 학습 패러다임을 채택하기로 결정했습니다.
우리의 결과는 보행 분석 모델을 사전 훈련하기 위해 대량, 고품질, 다양한 데이터 세트가 필요함을 의미합니다. 우리는 DenseGait에 대한 사전 훈련이 크기 증가, 변형 수 및 평균 걷기 지속 시간으로 인해 GREW에 비해 일관된 정확도 향상을 제공한다는 것을 보여주었습니다[12]. 그러나 가장 중요한 이점은 사용 가능한 교육 데이터의 양이 적은 상황에서 발생합니다. 우리의 결과는 처음부터 훈련하는 것이 적당한 양의 데이터(예: 개인당 10개 시퀀스)를 사용하여 미세 조정하는 것보다 훨씬 더 나쁜 결과를 가져온다는 것을 보여줍니다. 현재 대부분의 보행 접근법은 엄격하게 통제된 환경의 실내에서 수행되므로 실제 상호 작용의 복잡성으로 일반화할 수 없습니다. 정확한 야생 행동 분석을 수행하려면 다양한 훈련 데이터 세트가 중요합니다. 특히 보행은 외부 환경 요인은 물론 내부 및 정서적 구성 요소에 의해 쉽게 영향을 받는 생체 인식 기능이기 때문입니다.

우리의 절제 연구는 더 작은 시공간 패치가 더 나은 다운스트림 결과에 도움이 된다는 것을 보여줍니다. 이러한 통찰력은 이전에 단일 패치에서 개별 뼈대를 처리하는 데 의존했던 뼈대 시퀀스에 대한 아키텍처의 향후 개발을 알려줍니다[12].
보행 분석을 현실적인 설정으로 가져오려는 동시 노력과 함께 우리의 작업을 통해 보행 인증 및 행동 분석을 실내 제어 환경에서 실외 실제 설정으로 전환할 수 있습니다. 야생에서의 보행 인식은 모션 기반 동작을 실시간으로 처리하는 스마트 센서와 효율적인 신경 아키텍처의 개발로 어디서나 보편화될 것입니다.


참고자료
1. 경수; 김 SM; 정S.; 김동훈 보행 패턴 분석 및 임상 하위군 식별: 후향적 관찰 연구. 의학 2020, 99, e19555. [상호참조] [PubMed]
2. 미칼락, J.; 트로제, NF; 피셔, J.; 볼마르, P.; 하이덴라이히, T.; Schulte, D. 슬픔과 우울증의 구현 - 불쾌감과 관련된 보행 패턴. 사이코솜. 메드. 2009, 71, 580-587. [상호참조] [PubMed]
3. 윌렘스, TM; Witvrouw, E.; 드 콕, A.; De Clercq, D. 신발 달리기 중 운동 관련 하퇴 통증에 대한 보행 관련 위험 요인. 메드. 과학. 스포츠 운동 2007, 39, 330-339. [상호참조] [PubMed]
4. 싱, 일본; 제인, S.; 아로라, S.; Singh, UP 비전 기반 보행 인식: 설문조사. IEEE 액세스 2018, 6, 70497-70527. [상호참조]
5. 마키하라, Y.; 닉슨, MS; Yagi, Y. 보행 인식: 데이터베이스, 표현 및 응용 프로그램. 계산. 비스. 참조. 가이드 2020,1–13.
6. 유, 에스.; 탄, D.; Tan, T. 시야각, 의복 및 운반 상태가 보행 인식에 미치는 영향을 평가하기 위한 프레임워크. 제18차 패턴 인식에 관한 국제 컨퍼런스(ICPR'06) 간행물, 중국 홍콩, 2006년 8월 20~24일;볼륨 4, 441~444페이지.
7. 주(Zhu), Z.; 구오, X.; 양, T.; 황, J.; 뎅, J.; 황, G.; 두, D.; 루, J.; Zhou, J. 야생에서의 보행 인식: 벤치마크. 2021년 10월 11~17일 캐나다 BC주 몬트리올에서 열린 IEEE ICCV(International Conference on Computer Vision) 회의 진행 중.
8. 차오, H.; 여기요.; 장, J.; Feng, J. Gaitset: 횡단 보행 인식을 위한 세트로서의 보행에 관한 것입니다. 2019년 1월 27일부터 2월 1일까지 미국 하와이주 호놀룰루에서 열린 AAAI컨퍼런스 간행물에서; 33권, 8126~8133페이지.
9. 팬, C.; 펭, Y.; 카오, C.; 리우, X.; 허우, S.; 치, J.; 황 Y.; 리, Q.; He, Z. Gaitpart: 보행 인식을 위한 시간적 부분 기반 모델. 컴퓨터 비전 및 패턴 인식에 관한 IEEE/CVF 컨퍼런스 간행물(미국 워싱턴주 시애틀, 2020년 6월 13~19일) 14225~14233페이지.
10. 코스마, A.; Radoi, IE WildGait: 원시 감시 스트림에서 보행 표현 학습. 센서 2021, 21, 8387. [CrossRef][PubMed]
For more information:1950477648nn@gmail.com